Unstructured нужен не для редактирования страниц PDF, а для превращения документов в машинно обрабатываемые элементы, фрагменты и данные для поиска, аналитики и RAG. На странице Xeon Live можно скачать Unstructured бесплатно и перейти к продукту; ниже разберём, как выбрать режим обработки, проверить PDF, собрать поток от источника до назначения и проконтролировать результат.
Что делает Unstructured и какой результат получает система
Unstructured закрывает промежуточный слой между исходным документом и системой, которая должна этот документ искать, анализировать или передавать языковой модели. Вместо одной длинной строки текста платформа формирует канонический JSON с типизированными элементами: заголовками, обычным текстом, таблицами, изображениями и служебными метаданными. Такая структура сохраняет больше контекста, чем простое копирование текста из PDF: downstream-система получает не только содержимое, но и признаки, по которым можно восстановить иерархию, страницу, происхождение и роль фрагмента.
Текущий Unstructured Pipelines строит обработку как последовательность Connect → Route → Transform → Chunk → Enrich → Embed → Persist. Источник подаёт данные, Partitioner выбирает способ извлечения и формирует элементы, Chunker собирает их в поисковые фрагменты, обогащения добавляют сведения о таблицах и изображениях, Embedder создаёт векторные представления, а Destination записывает готовый результат. Не каждый поток обязан использовать все этапы: для выгрузки структурированного JSON достаточно меньшего набора, для семантического поиска обычно добавляют chunking и embedding.
Практическая граница продукта — Unstructured не является PDF-редактором. Здесь нет задачи перенести абзац на странице, стереть объект, заменить шрифт или переставить листы. Сначала исходный файл доводят до нужного состояния, а затем превращают его в структурированные данные. Для общего понимания самого формата PDF полезен разбор устройства и способов работы с PDF; Unstructured начинается там, где документ уже готов к машинной обработке.
Что проверять в каноническом JSON
Вместо проверки только количества символов смотрят на типы элементов и их последовательность. Заголовок должен оставаться Title, связный абзац — NarrativeText, таблица — Table, изображение — Image. Платформа использует более двадцати типов элементов; точный набор зависит от документа. Метаданные позволяют сохранить имя и тип файла, происхождение, иерархию и другие сведения. Для PDF особенно важны page_number и координаты там, где они включены выбранной стратегией: по ним приложение связывает найденный текст с конкретной страницей и областью.
Готовность результата к RAG определяет не валидность JSON сама по себе, а сохранённый смысл. Двухколоночный отчёт может быть синтаксически безупречен и при этом иметь неправильный порядок чтения; таблица может превратиться в линейный текст, где потеряна связь между заголовками и ячейками. Поэтому контрольная выборка должна включать обычный электронный PDF, скан, страницу с таблицей, многостолбцовую страницу и документ с иллюстрациями. Такой набор показывает реальные границы конфигурации до массовой загрузки.
Карта интерфейса: Connectors, Workflows, Partitioner и Jobs
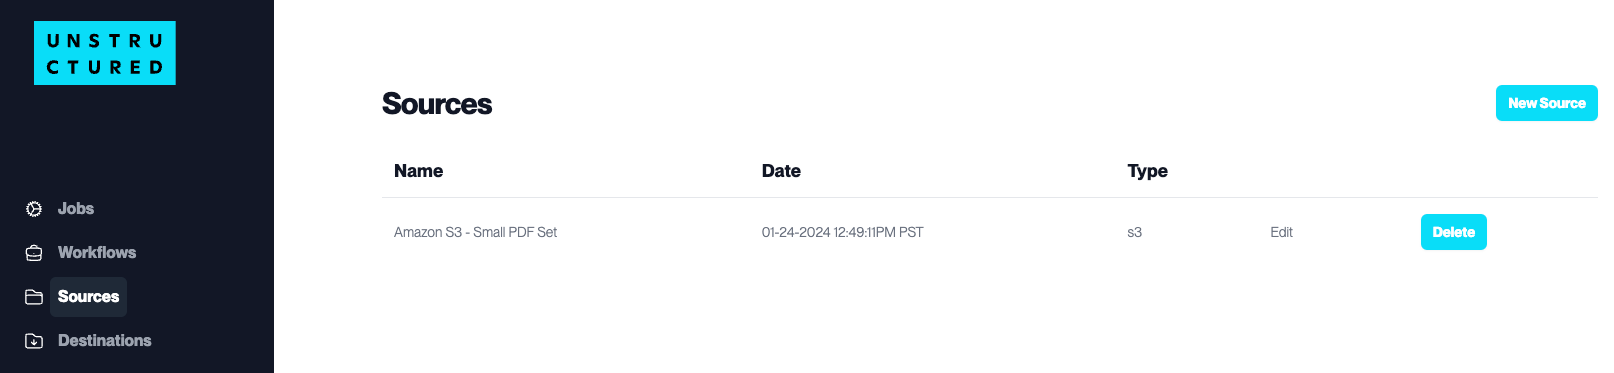
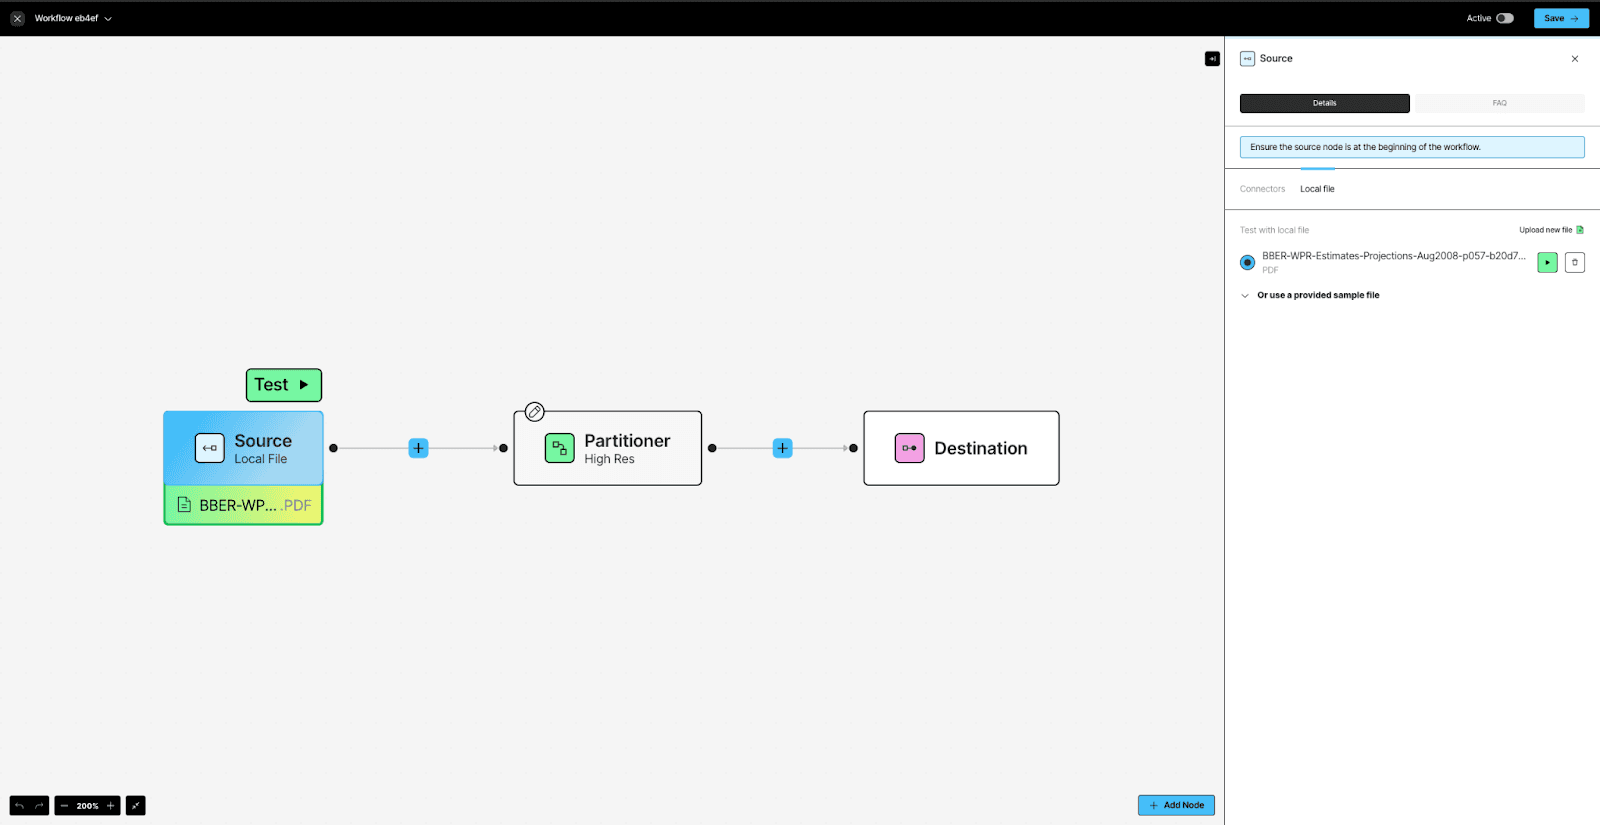
В актуальном веб-интерфейсе основной рабочий путь проходит через левую навигацию. В Connectors находятся Sources и Destinations. Workflows открывает список потоков и визуальный конструктор. Jobs показывает выполнения, состояние и длительность. В самом конструкторе документ идёт слева направо: Source → Partitioner → дополнительные узлы → Destination. При выборе узла открывается панель его параметров; дополнительные этапы добавляются кнопкой с плюсом или Add Node.
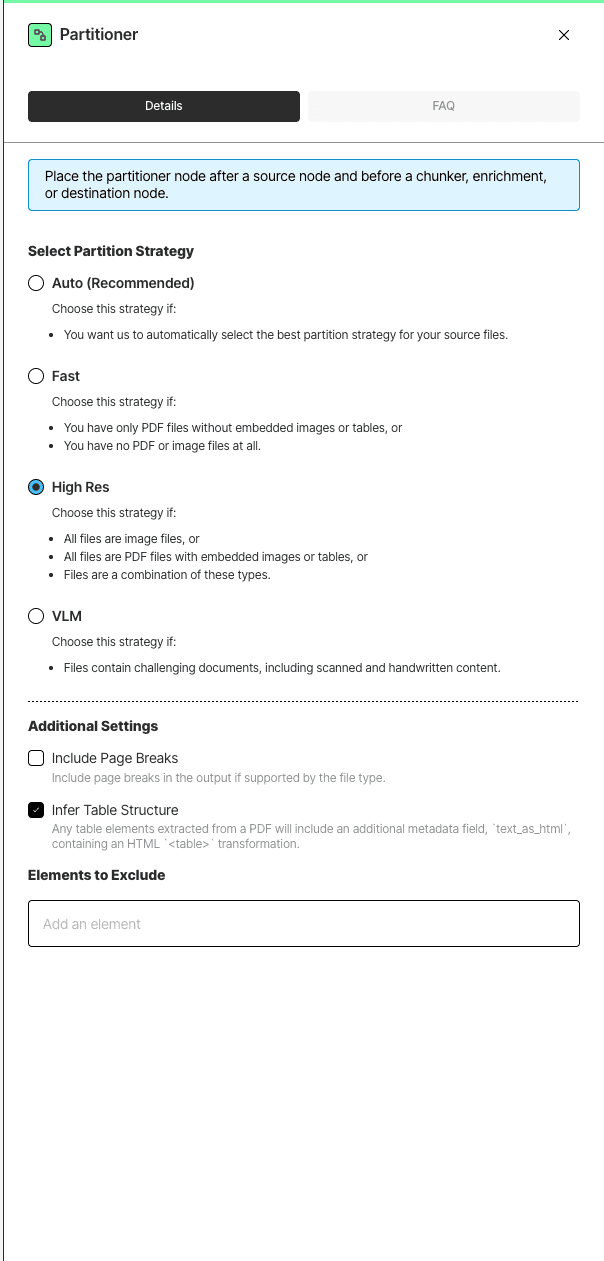
Partitioner — центральная точка качества извлечения. В Unstructured Pipelines доступны Auto, Fast, High Res и VLM. Auto рекомендован как стартовый вариант и для PDF принимает решение постранично: страницы только с извлекаемым текстом без обнаруженных изображений и таблиц идут по Fast, остальные направляются в VLM или High Res в зависимости от сложности. Fast предназначен для текстовых документов. High Res нужен для остальных поддерживаемых типов и для получения bounding box. VLM ориентирован на максимально качественную визуальную обработку PDF и изображений поддерживаемых форматов.
Как читать схему узлов и не перепутать порядок
Источник должен стоять в начале, назначение — в конце. При совместном использовании обогащений и Chunker сначала выполняют обогащения, затем chunking; документация прямо предупреждает, что Chunker перед enrichment-узлами способен привести к неполному или отсутствующему результату обогащения. Partitioner и Embedder относятся к Transform, Chunker и остальные enrichments добавляются через Enrich. Визуальный дизайнер допускает сохранить незавершённую схему, но активировать и запускать её нельзя, пока нет корректного маршрута и необходимых source/destination для рабочего прогона.
Для локальной проверки действует отдельная логика: в Source можно не выбирать коннектор, а загрузить локальный файл и нажать Test. Результат показывается на экране, его можно сохранить в локальный JSON. Такой поток нельзя использовать для отправки результата в удалённое назначение и нельзя сохранить как обычный активный pipeline. Поэтому локальный файл удобен именно как лабораторный образец, а не как постоянный источник производственного потока.
Как проверить один PDF перед построением рабочего потока
Самый безопасный первый шаг — не подключать архив целиком, а прогнать один характерный PDF в визуальном конструкторе. Выберите файл, в котором есть те элементы, ради которых строится обработка: заголовки, нумерация, таблицы, сканированные фрагменты или изображения. Для технической документации полезна страница с двумя колонками и рисунком; для договора — несколько уровней разделов и приложение; для отчёта — таблица с многострочными заголовками. Такой образец быстрее выявляет неправильную стратегию, чем идеально простой документ.
Шаг 1. Запустите локальный тест и зафиксируйте базовый результат
1. Откройте Workflows и создайте новый поток через Build it Myself. 2. В Source не выбирайте удалённый connector: перетащите PDF в область локального файла или выберите его через диалог. 3. Нажмите Test. 4. Дождитесь появления результата и сохраните JSON локально, чтобы можно было сравнивать последующие варианты. 5. Запишите, какие страницы содержат таблицы, изображения и участки с ошибочным порядком чтения. 6. Не меняйте несколько параметров одновременно: первая выгрузка должна стать контрольной точкой.
В первой проверке ищите не единичную опечатку, а системные признаки: пропавшие заголовки, переставленные колонки, объединённые абзацы, раздробленные списки, потерянные ячейки. Найдите в JSON фразу с середины документа и сопоставьте соседние элементы с исходной страницей. Затем выберите строку из таблицы и убедитесь, что она относится к Table, а не рассыпалась по нескольким несвязанным NarrativeText. Если нужны координаты, проверьте их наличие до дальнейшей интеграции.
Шаг 2. Сравните Auto с целевой стратегией
Откройте Partitioner и сначала оставьте Auto. Он является базовым вариантом для смешанных PDF и маршрутизирует страницы по содержимому. После контрольного прогона меняйте режим только при конкретной проблеме. Для чистого born-digital PDF без изображений и таблиц сравните Auto с Fast. Для сложной геометрии и задачи с bounding box сравните Auto с High Res. Для PDF или изображения, где смысл сильно зависит от визуальной компоновки, сравните Auto с VLM. Каждый вариант прогоняйте на том же файле и сохраняйте отдельный результат.
- Сравните полноту текста: одна и та же контрольная фраза должна находиться в ожидаемом элементе.
- Проверьте порядок чтения: элементы соседних колонок не должны перемешиваться.
- Проверьте таблицу: заголовки, строки и значения должны оставаться связаны.
- Проверьте разметку разделов: крупные заголовки не должны превращать каждый короткий абзац в новый смысловой блок.
- Проверьте метаданные страницы и координаты, когда приложение будет показывать источник ответа.
Для OCR полезно отдельно взять скан. В локальной open-source функции partition_pdf OCR применяется, когда текст в PDF недоступен; в облачном Pipelines маршрутизация зависит от выбранной стратегии. Если задача именно в распознавании текста сканов, дополнительно можно сверить подходы по инструкции по OCR в PDF. Результат Unstructured оценивайте шире OCR: важны не только символы, но и структура документа.
Шаг 3. Зафиксируйте критерий приёмки до массового запуска
Составьте короткий эталон: несколько фраз, одна таблица, один заголовок, одна область со сложным layout. Для каждого пункта запишите ожидаемый элемент и страницу. После каждого изменения Partitioner повторяйте ровно этот набор проверок. Такой подход отделяет улучшение качества от субъективного впечатления. Если новый режим исправил таблицу, но сломал порядок обычного текста, это не готовая конфигурация; нужен отдельный маршрут для такого класса документов или другой режим.
Контрольный JSON сохраните вместе с названием конфигурации. В производственном проекте это становится регрессионным набором: после изменения Partitioner, Chunker или enrichment можно быстро понять, что именно изменилось. Это особенно важно потому, что изменение параметров существующего workflow само по себе не заставляет Unstructured повторно обработать неизменённые документы; повторный прогон нужно инициировать осознанно через Reprocess All.
Как разобрать PDF локально через библиотеку unstructured
Когда нужен кодовый путь без визуального Pipelines, используйте open-source библиотеку unstructured. Для локальной обработки PDF с моделью анализа документа установите пакет с local inference в отдельном виртуальном окружении: pip install "unstructured[local-inference]". Затем импортируйте функцию partition_pdf из unstructured.partition.pdf. Минимальный вызов выглядит как elements = partition_pdf("document.pdf"). Он возвращает список элементов документа, с которыми дальше работает Python-код.
Шаг 1. Выберите стратегию partition_pdf по реальному типу PDF
В open-source функции набор стратегий отличается от облачного Pipelines: доступны auto, hi_res, ocr_only и fast. Это важно не смешивать. Fast использует pdfminer и подходит, когда PDF имеет извлекаемый текст. Ocr_only прогоняет документ через Tesseract и затем partition_text; документация отдельно отмечает его как полезный вариант для многостолбцовых документов без извлекаемого текста, поскольку hi_res способен ошибаться в порядке таких элементов. Hi_res анализирует layout и нужен, когда критична классификация элементов и извлечение image/table blocks. Auto выбирает между доступными путями на основании характеристик файла и переданных параметров.
Сначала сделайте вызов partition_pdf("document.pdf", strategy="auto"). Выведите для первых элементов type(element).__name__, короткий фрагмент str(element) и element.metadata.page_number. Затем повторите вызов с явной стратегией только для проблемного класса файла. Если в PDF есть нормальный текстовый слой, сравните fast с auto. Если текста нет, сравните ocr_only с hi_res на странице с несколькими колонками. Для layout-sensitive документа сравните hi_res с auto. Не выбирайте hi_res только из-за названия: качество проверяется на эталоне.
Шаг 2. Настройте OCR и извлечение визуальных блоков
Языки OCR задаются параметром languages. Например, partition_pdf("document.pdf", languages=["eng", "deu"]) подключает английский и немецкий языковые пакеты; названия языков соответствуют пакетам Tesseract. OCR применяется, когда текст уже нельзя извлечь из PDF напрямую. Для русско-английского архива установите необходимые языковые данные Tesseract и передайте соответствующие обозначения, после чего на контрольном скане сравните имена собственные, цифры и знаки пунктуации.
Для извлечения Image и Table в виде отдельных image blocks требуется hi_res. Актуальная документация постепенно заменяет старый extract_images_in_pdf параметром extract_image_block_types. Практический порядок такой: поставьте strategy="hi_res", задайте extract_image_block_types=["Image", "Table"], выберите сохранение в каталог через extract_image_block_output_dir либо передачу в payload через extract_image_block_to_payload. После выполнения посчитайте количество файлов/полей и сопоставьте их с визуальными объектами на исходной странице. Если кадрирование обрезает контент, настраиваются переменные padding, а не ручная правка каждого результата.
Шаг 3. Сохраните элементы так, чтобы их можно было проверять повторно
Не переходите сразу от elements к индексации. Сначала сериализуйте результат в собственный JSON-файл и сохраните минимум тип элемента, text и metadata, которые действительно используются дальше. Для каждой контрольной страницы проверьте число элементов и порядок. Если проекту нужны координаты, убедитесь, что downstream-код знает систему координат и размер страницы. Если нужны таблицы, проверьте структурированное представление до chunking: после нарезки отлаживать исходную таблицу значительно сложнее.
Отделяйте partitioning от chunking во время настройки. Разбор PDF, OCR и layout inference заметно тяжелее, чем повторная нарезка уже готовых элементов. Поэтому один раз сохраните исходный набор элементов, а затем меняйте только функцию chunk_elements или chunk_by_title. Так цикл эксперимента становится быстрее и не вносит шум от повторного распознавания документа.
Как подключить источник, назначение и собрать производственный workflow
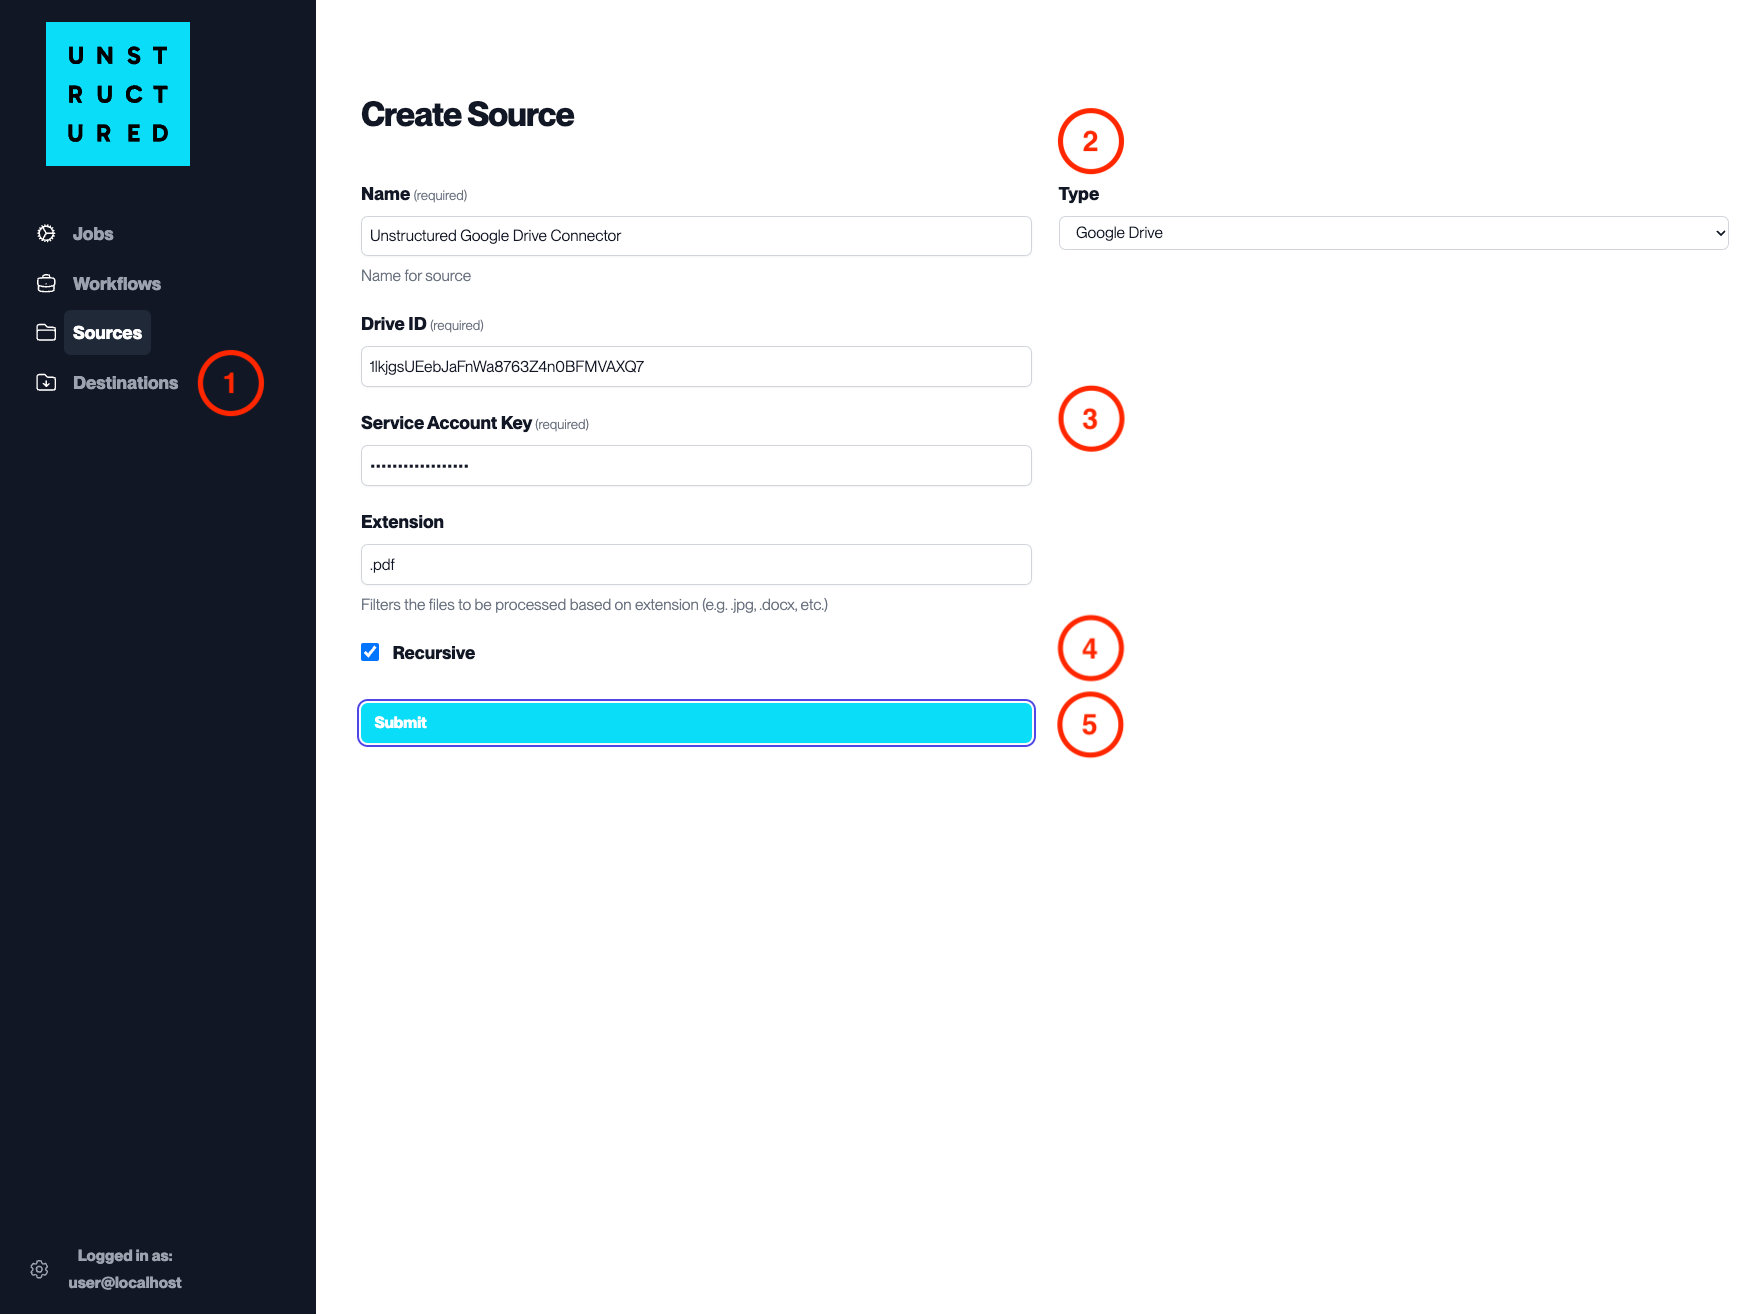
После одиночного теста настройте постоянные подключения. В актуальном интерфейсе источники создаются через Connectors → Sources, назначения — через Connectors → Destinations. Логика одинакова: New или Create Connector, уникальное имя, Provider, Continue, параметры конкретного сервиса, затем Save and Test. Для источника используйте учётные данные только с необходимыми правами чтения; для назначения — только с правами, достаточными для записи в выбранную коллекцию, индекс, таблицу или bucket.
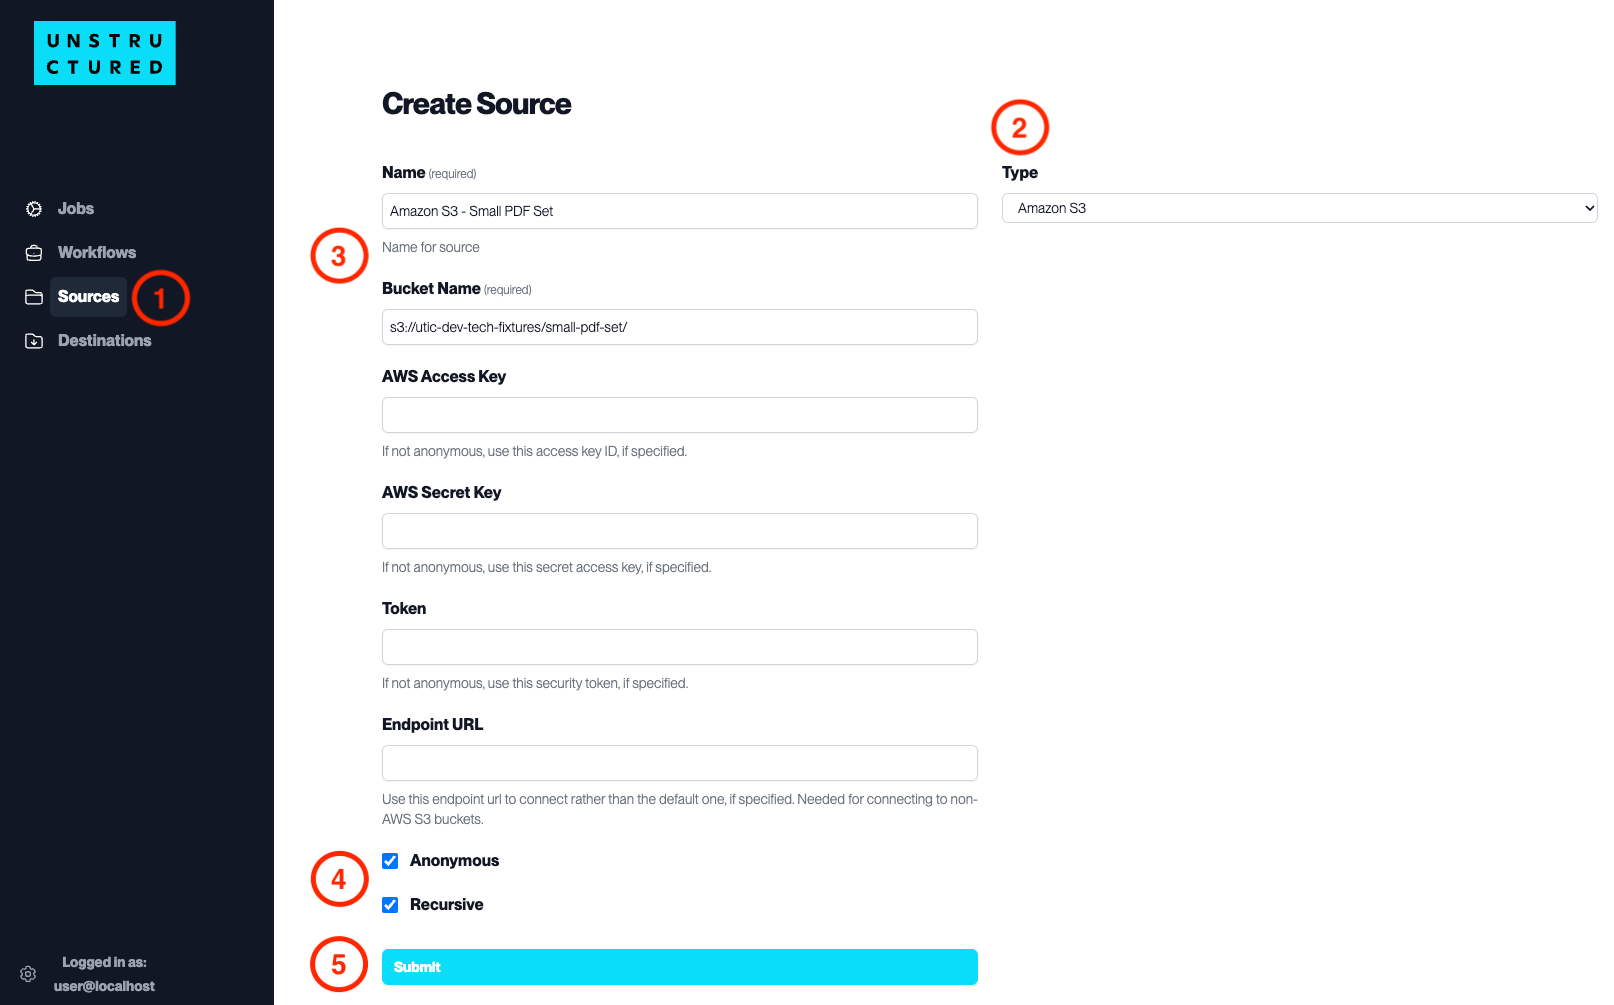
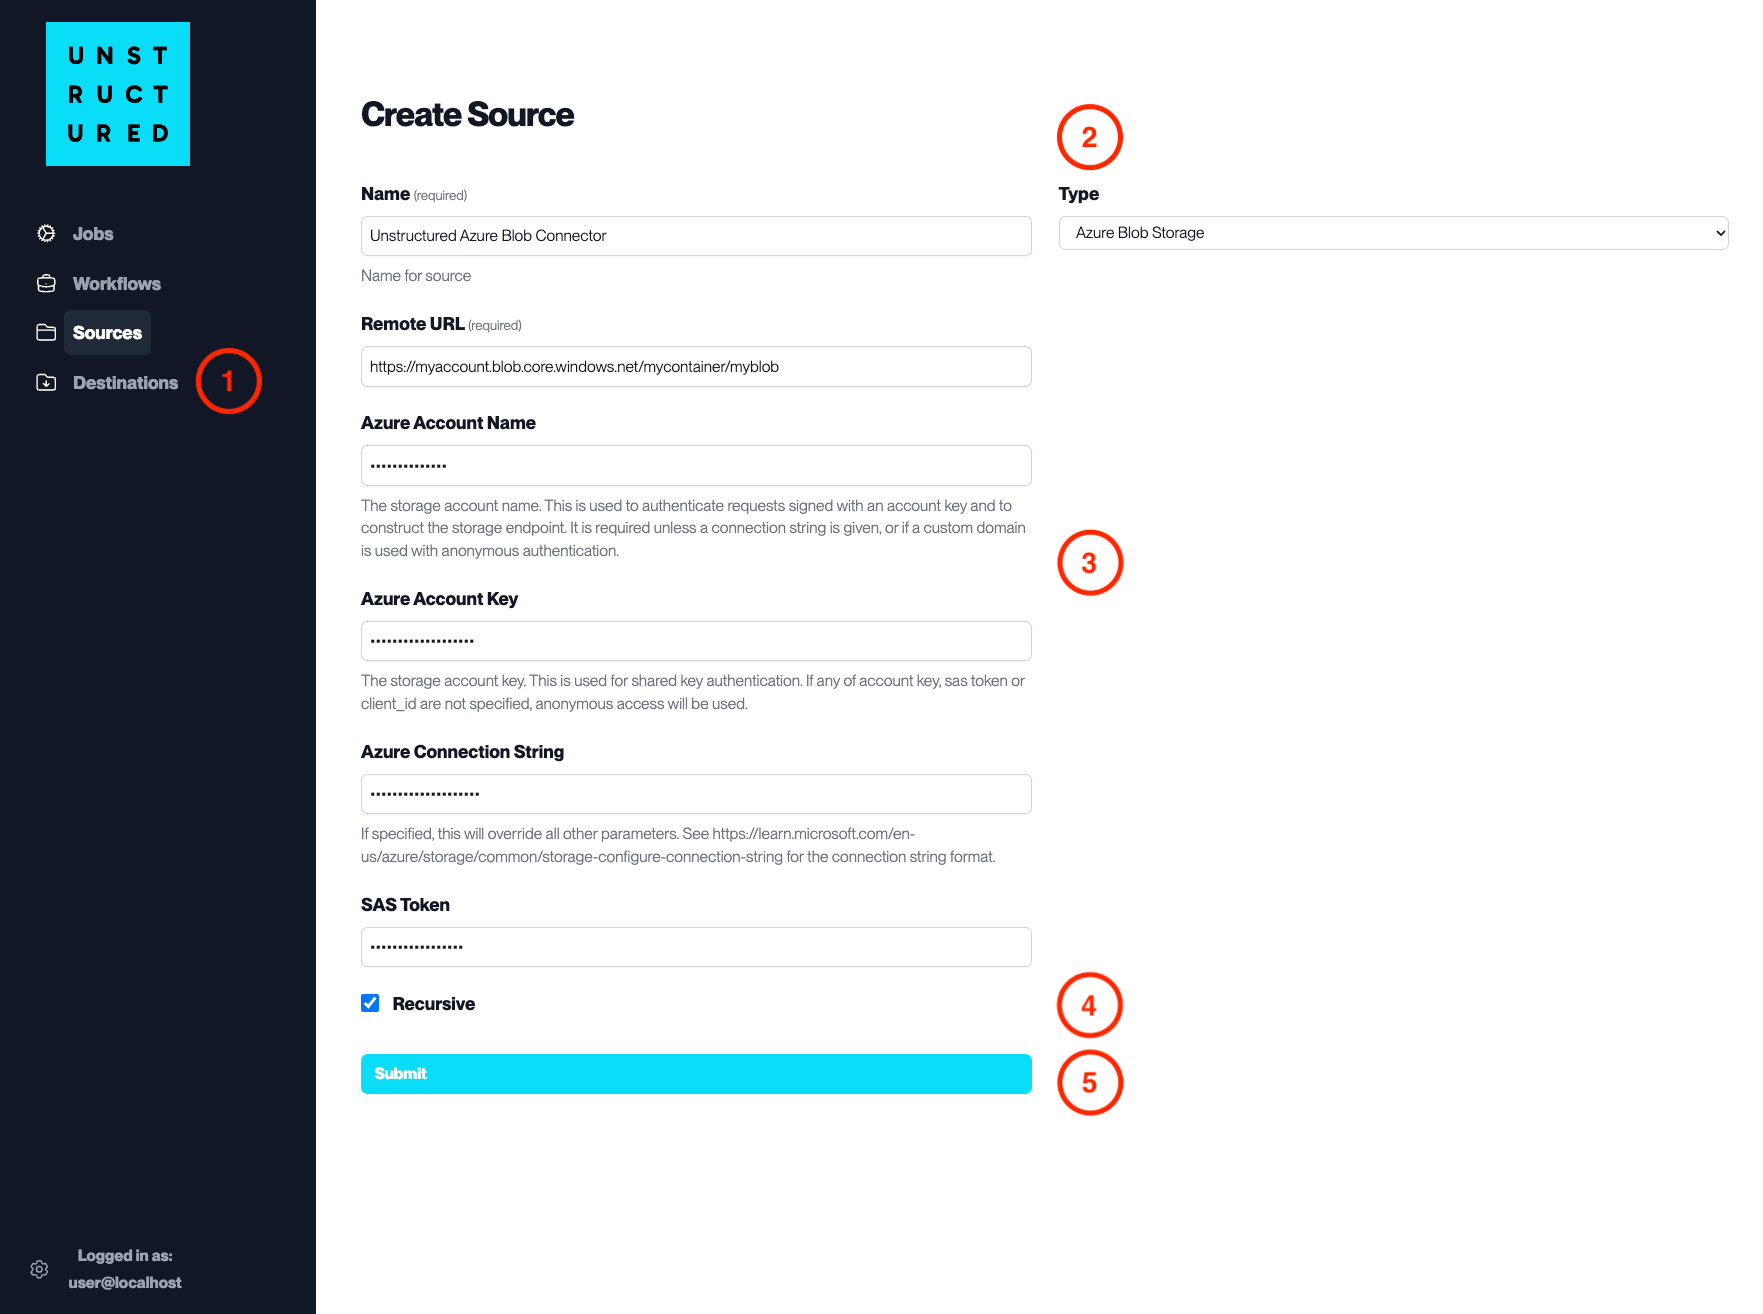
Шаг 1. Создайте Source и ограничьте область чтения
Откройте Connectors → Sources → New/Create Connector. Введите имя, которое объясняет происхождение данных, затем выберите Provider и нажмите Continue. Заполните поля конкретного источника и завершите Save and Test. Для S3 укажите bucket и путь, для Google Drive — нужную область диска, для SharePoint или другого корпоративного сервиса — соответствующий сайт или каталог. Не начинайте с корня большого хранилища: сначала выделите небольшую тестовую папку с известным составом документов.
После Save and Test проверьте не только успешное соединение, но и фактическую область видимости. Положите в тестовую папку один новый файл, один изменённый и один файл неподдерживаемого для вашего сценария типа. Убедитесь, что первый читается, второй определяется как обновлённый при следующем запуске, а лишний формат не попадает в рабочий поток либо обрабатывается по ожидаемому правилу. Такая проверка ловит ошибку пути и слишком широкий recursive-обход до индексации архива.
Шаг 2. Создайте Destination и согласуйте схему результата
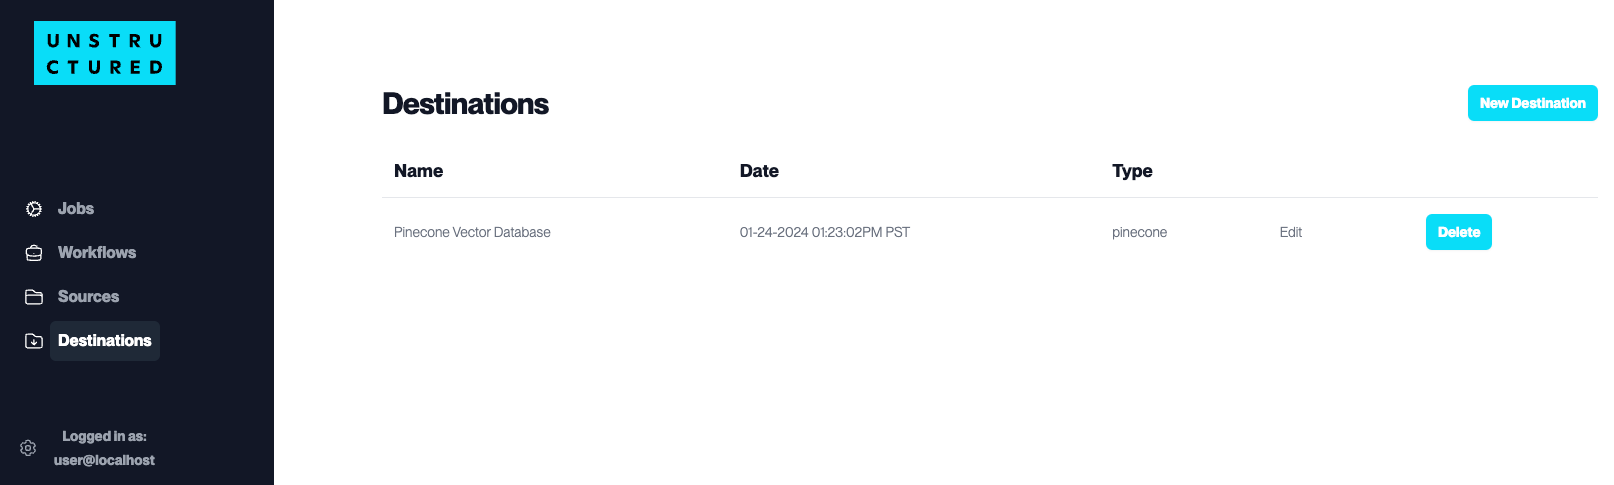
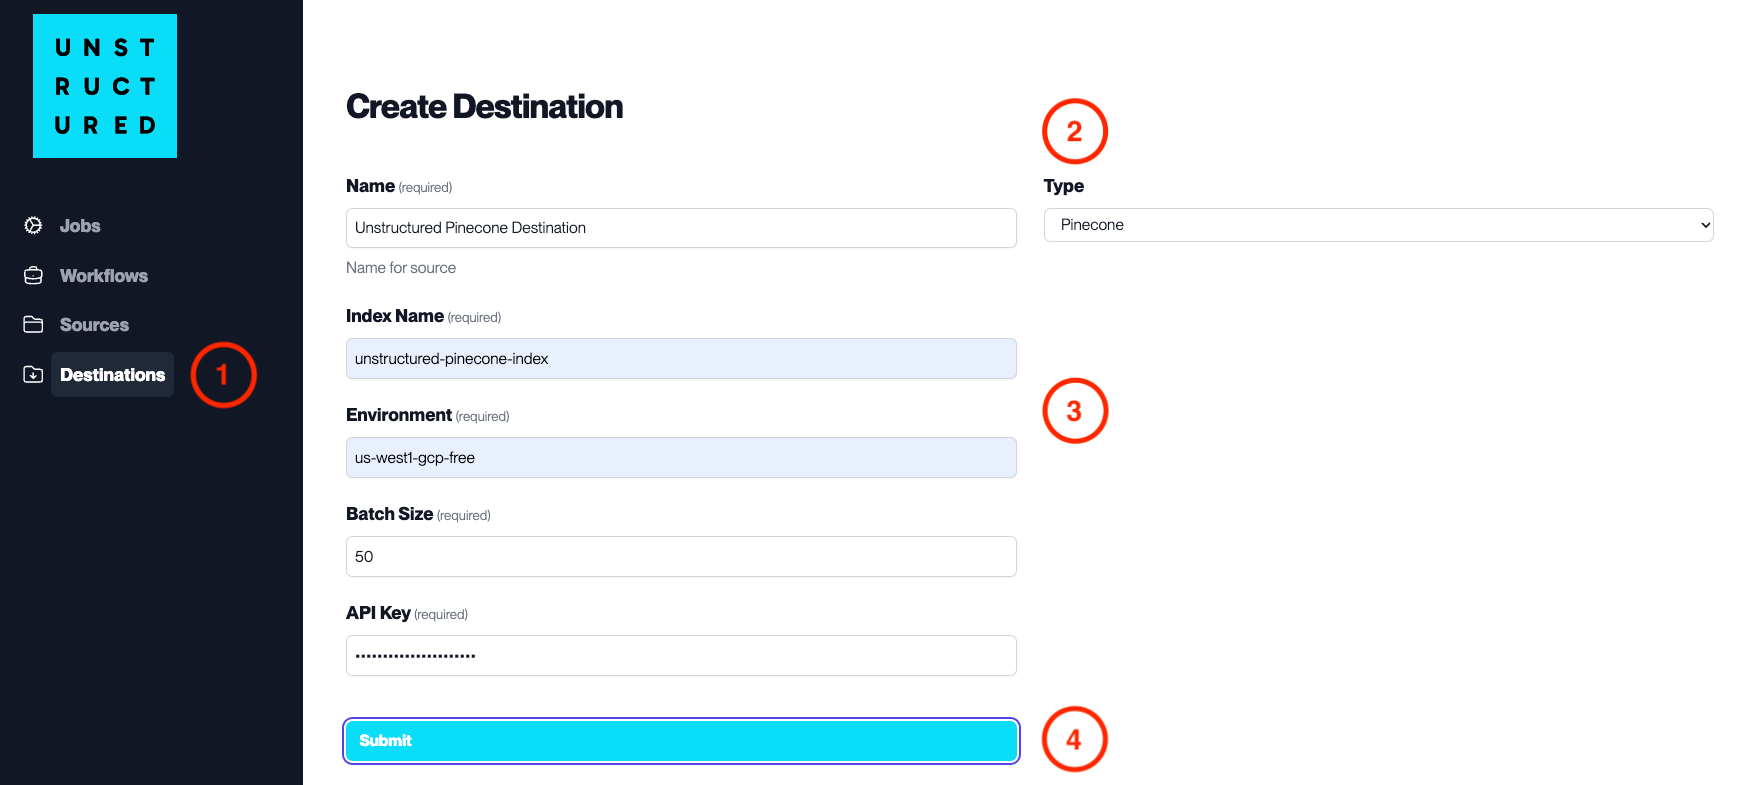
Перейдите Connectors → Destinations → New/Create Connector. Выберите Provider, заполните поля и выполните Save and Test. Unstructured поддерживает назначения разных классов: объектные хранилища, PostgreSQL, Elasticsearch/OpenSearch, MongoDB, Pinecone, Qdrant, Redis, Weaviate и другие. До первого рабочего Job подготовьте структуру назначения: коллекцию или индекс, ожидаемые поля текста и metadata, правила идентификатора и, при использовании embeddings, совместимую размерность.
Проверка назначения должна отвечать на три вопроса. Во-первых, создаётся ли запись и можно ли её прочитать обратно. Во-вторых, повторная обработка того же документа обновляет запись по ожидаемому ID или создаёт дубликат. В-третьих, удаление или переименование источника обрабатывается так, как требуется вашему приложению. Unstructured ведёт собственную историю документов для workflow, но downstream-хранилище всё равно должно иметь понятную политику upsert и очистки.
Шаг 3. Соберите граф и проведите первый контролируемый Job
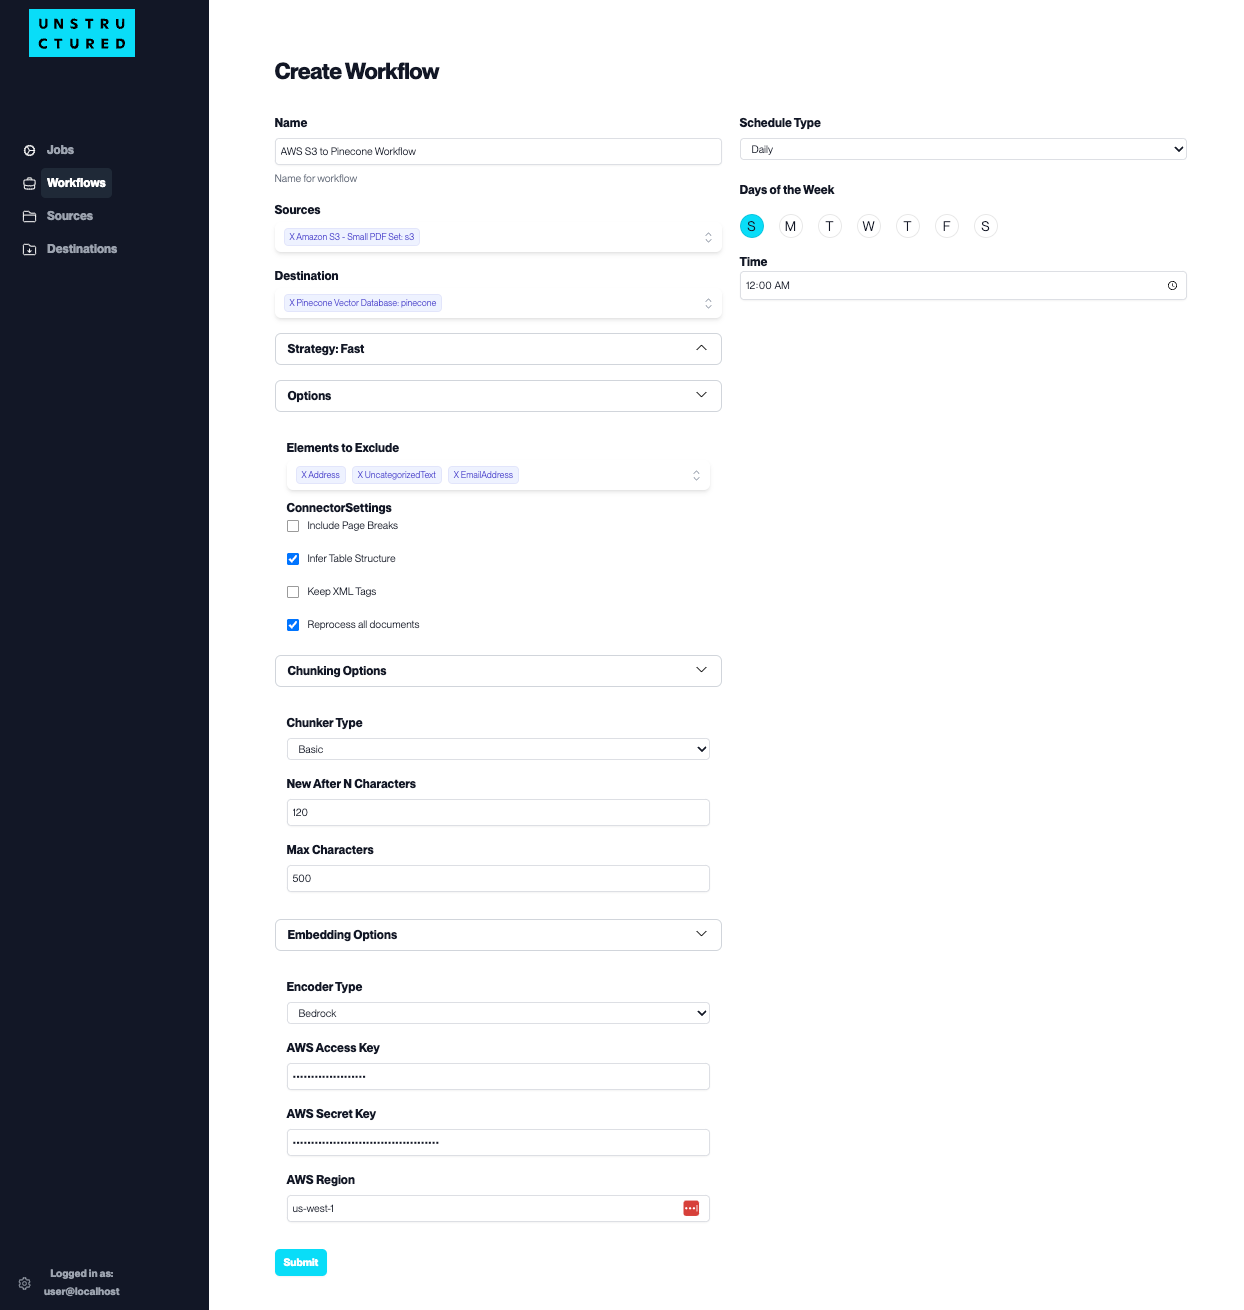
Откройте Workflows → New Workflow → Build it Myself → Continue. В Details задайте уникальное имя. В Source выберите созданный connector и сохраните узел. В Destination выберите созданное назначение и сохраните. Через плюс добавьте нужные Transform и Enrich узлы. Partitioner размещайте после источника; enrichment выполняйте до Chunker; Embedder ставьте там, где вектор создаётся внутри Unstructured. Сохраните workflow и не включайте расписание, пока ручной Job не прошёл на тестовой папке.
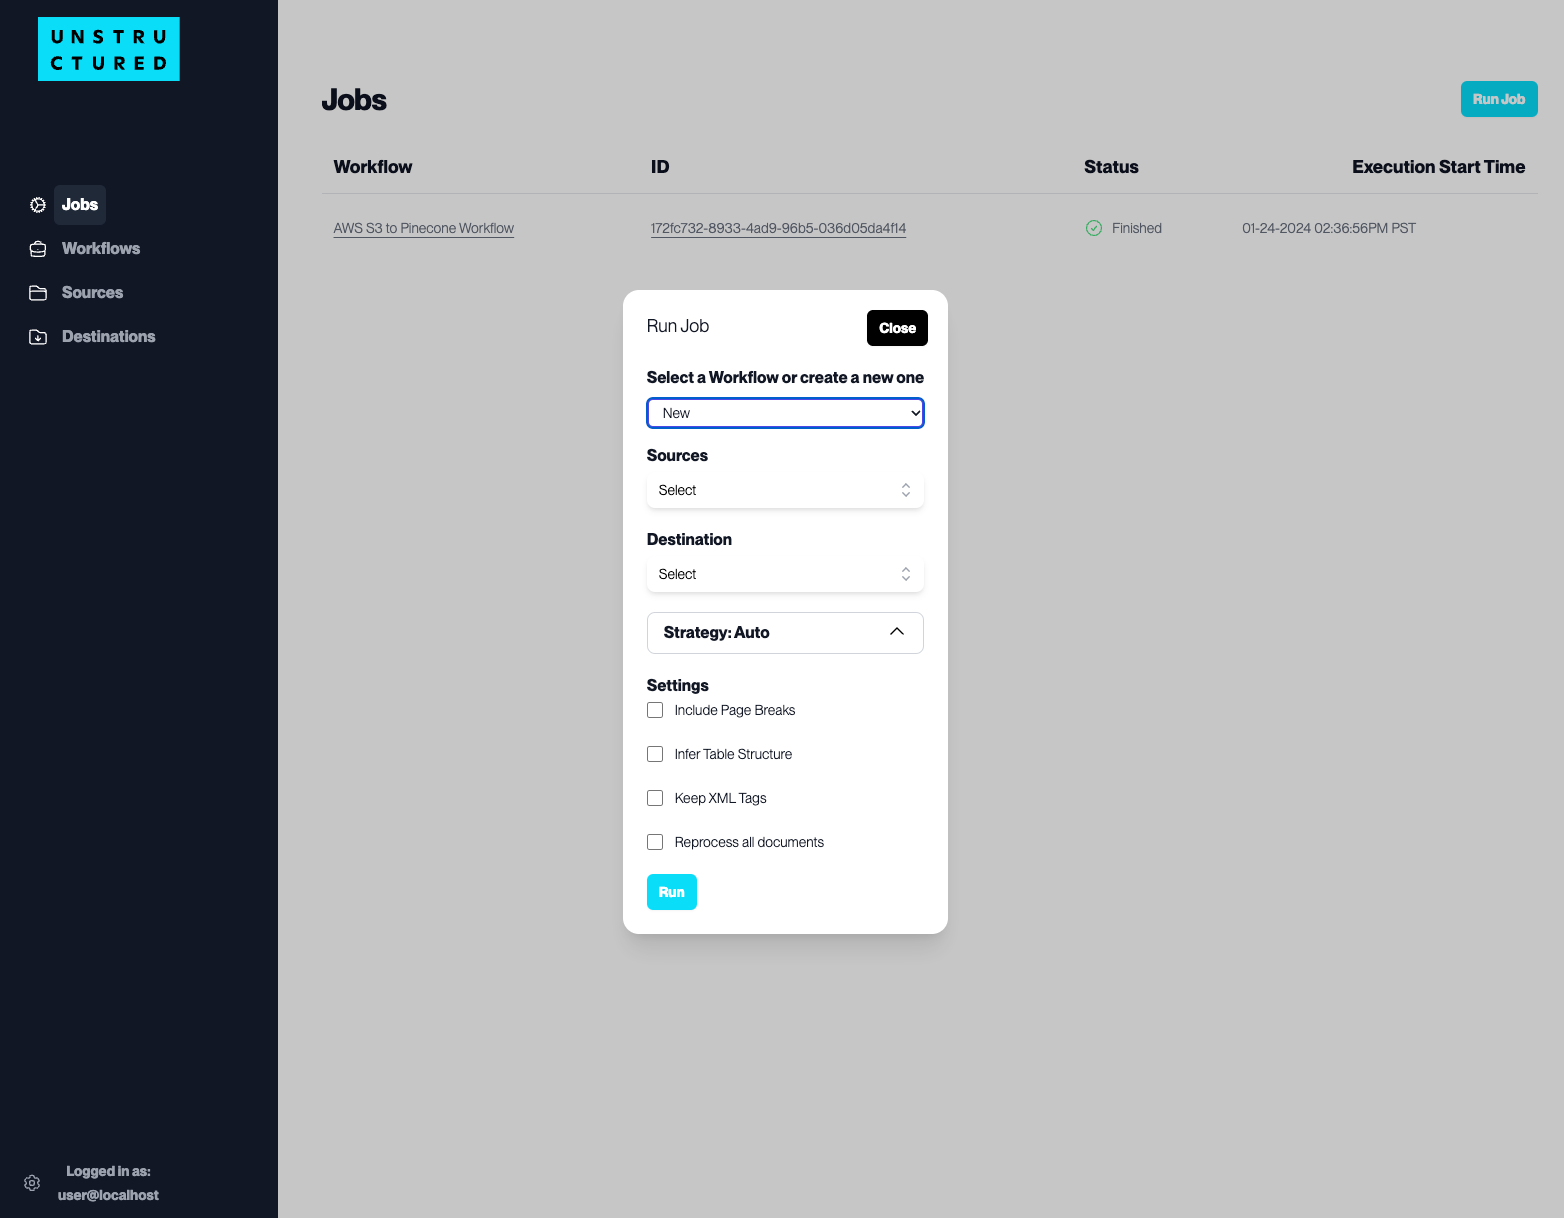
Запустите поток вручную через Workflows → Run в строке нужного workflow. После завершения откройте Jobs и проверьте статус. Затем откройте несколько записей в destination и сравните их с локальным тестом: типы элементов, тексты, metadata и chunks должны соответствовать выбранной конфигурации. Только после этого расширяйте путь источника или включайте расписание. Такой порядок отделяет проблему подключения от проблемы качества partitioning и от проблемы схемы хранилища.
Как настроить chunking и обогащения для RAG
Chunking стоит настраивать после того, как исходные элементы уже стабильны. В Pipelines доступны Basic, By Title, By Page и By Similarity. В open-source библиотеке текущие функции дают basic и by_title. Не переносите названия между двумя режимами работы без проверки: облачная платформа предлагает больше вариантов. Общий принцип одинаков — chunk строится из уже распознанных элементов и должен сохранить смысловые границы, а не просто нарезать строку через равное число символов.
Шаг 1. Выберите стратегию по структуре документа
Для документа с хорошими заголовками начните с By Title: границы разделов дают естественную единицу поиска. Для ровного текста без устойчивой иерархии используйте Basic и управляйте размером. Для анкет, слайдов или документов, где страница является самостоятельной записью, проверьте By Page. By Similarity полезен, когда смысловые переходы важнее формальных заголовков: он объединяет последовательные элементы по близости и требует embedding-модели. Выбор подтверждайте не средней длиной chunk, а качеством извлечения на контрольных вопросах.
Создайте набор из 15–30 контрольных вопросов к нескольким документам и для каждого отметьте ожидаемый фрагмент. После каждой конфигурации chunking сохраните список chunks и проверьте, находится ли нужный фрагмент без лишнего соседнего материала. Если ответ размазан по двум chunks, граница слишком агрессивна. Если один chunk содержит несколько независимых тем, он слишком велик или By Title не распознаёт заголовки так, как вы ожидали.
Шаг 2. Настройте пределы размера и overlap без лишних дублей
В open-source chunking hard limit задаёт max_characters, а new_after_n_chars работает как мягкая граница: после неё следующий целый элемент уже можно перенести в новый chunk, не разрезая семантическую единицу. Overlap по умолчанию нужен в первую очередь при разрезании слишком большого элемента; overlap_all распространяет перекрытие и на обычные chunks и способен загрязнить их повторяющимся текстом. В интерфейсе Pipelines параметры называются сходно, но окончательный размер нужно согласовать с выбранной embedding-моделью.
Практический тест выполняйте поэтапно. Сначала отключите избыточное перекрытие и посмотрите, сколько ответов теряется на границах. Затем добавьте минимально необходимое overlap и повторите тот же набор вопросов. Сравнивайте не только recall, но и количество почти одинаковых результатов в выдаче. Если поисковик возвращает три соседних chunks с одинаковым вступлением, overlap велик либо downstream-ранжирование не группирует соседние фрагменты.
Шаг 3. Добавьте enrichments только там, где они участвуют в поиске
Для изображений и таблиц Pipelines умеет добавлять summary descriptions, а также table-to-HTML и generative OCR в совместимых конфигурациях. С Auto или High Res нужное обогащение добавляется отдельным node; с VLM такие описания формируются в соответствующем пути без отдельного enrichment node, и отдельные узлы для этих функций не допускаются. Fast не создаёт image/table summaries и generative OCR. Поэтому сначала выберите Partitioner, затем совместимые обогащения — обратный порядок приводит к конфигурации, которая не даст ожидаемых полей.
Добавляйте enrichment по измеримому сценарию. Для каталога схем полезно описание изображений, для финансовых отчётов — структура и описание таблиц, для чистой текстовой базы дополнительный визуальный слой часто не участвует в выдаче. После включения нового node повторите контрольные вопросы именно к тем объектам, ради которых он добавлен. Если новые поля не улучшают поиск или не используются приложением, их хранение и обработка становятся лишним этапом.
Как запускать Jobs, расписание и повторную обработку без дублей
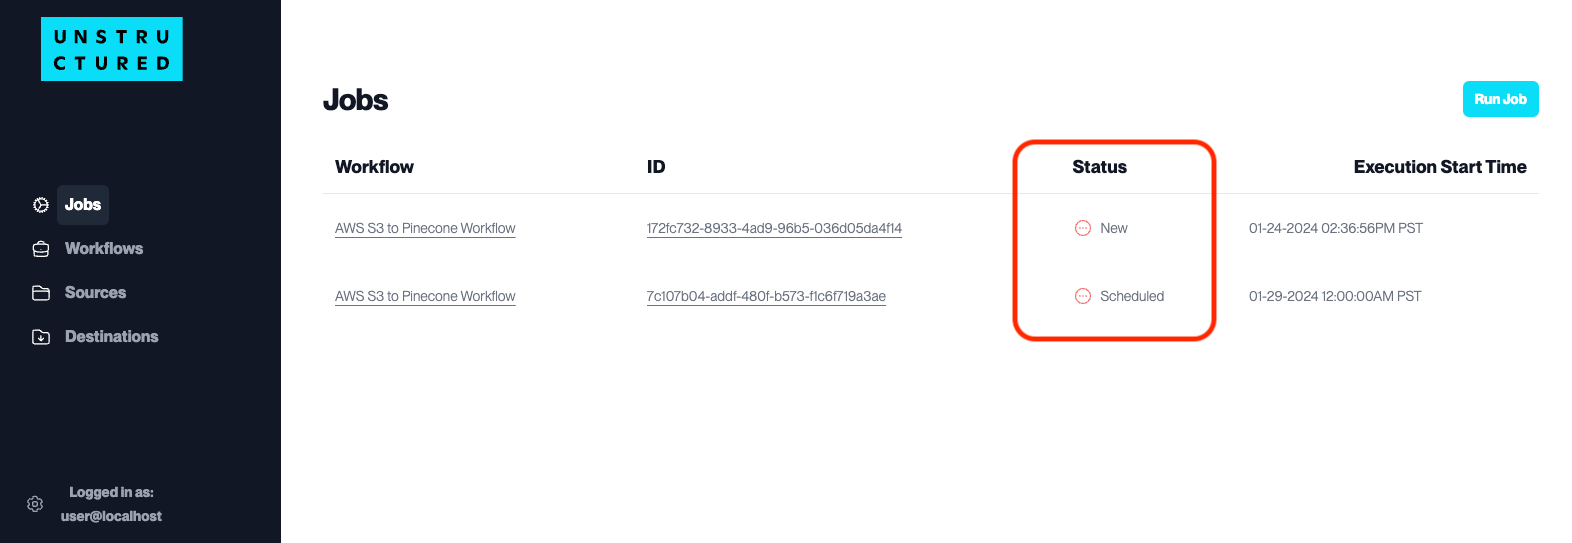
Когда ручной Job стабилен, автоматизация сводится к расписанию и правилам повторной обработки. Jobs dashboard показывает Status, Job ID, время создания, workflow и duration. Рабочий Job запускается из Workflows кнопкой Run; детали открываются из списка Jobs. Для регулярного потока расписание задаётся в Workflow через Schedule/Repeat Run. Перед включением расписания нужно решить, должны ли неизменённые документы обрабатываться снова.
Шаг 1. Настройте Reprocess All под режим обновления данных
Откройте настройки workflow и найдите Reprocess All. При включённом параметре документы источника повторно обрабатываются на каждом запуске. При выключенном Unstructured для поддерживаемых connectors пропускает неизменённые объекты и обрабатывает новые либо изменённые версии. Для S3 и Azure Blob версия может опираться на ETag, для ряда других провайдеров — на их собственный version ID. Переименование документа меняет record ID и приводит к повторной обработке как нового объекта.
После изменения Partitioner, Chunker, Embedder или enrichment не рассчитывайте, что неизменённые файлы автоматически получат новые данные. Документация явно указывает: изменение конфигурации workflow не инициирует полную переобработку. Для миграции включите Reprocess All хотя бы на один контролируемый запуск, убедитесь, что destination обновлён, и только затем верните инкрементальный режим. Иначе в одном индексе окажутся записи, созданные разными правилами.
Шаг 2. Отслеживайте состояние и разбирайте частичные ошибки
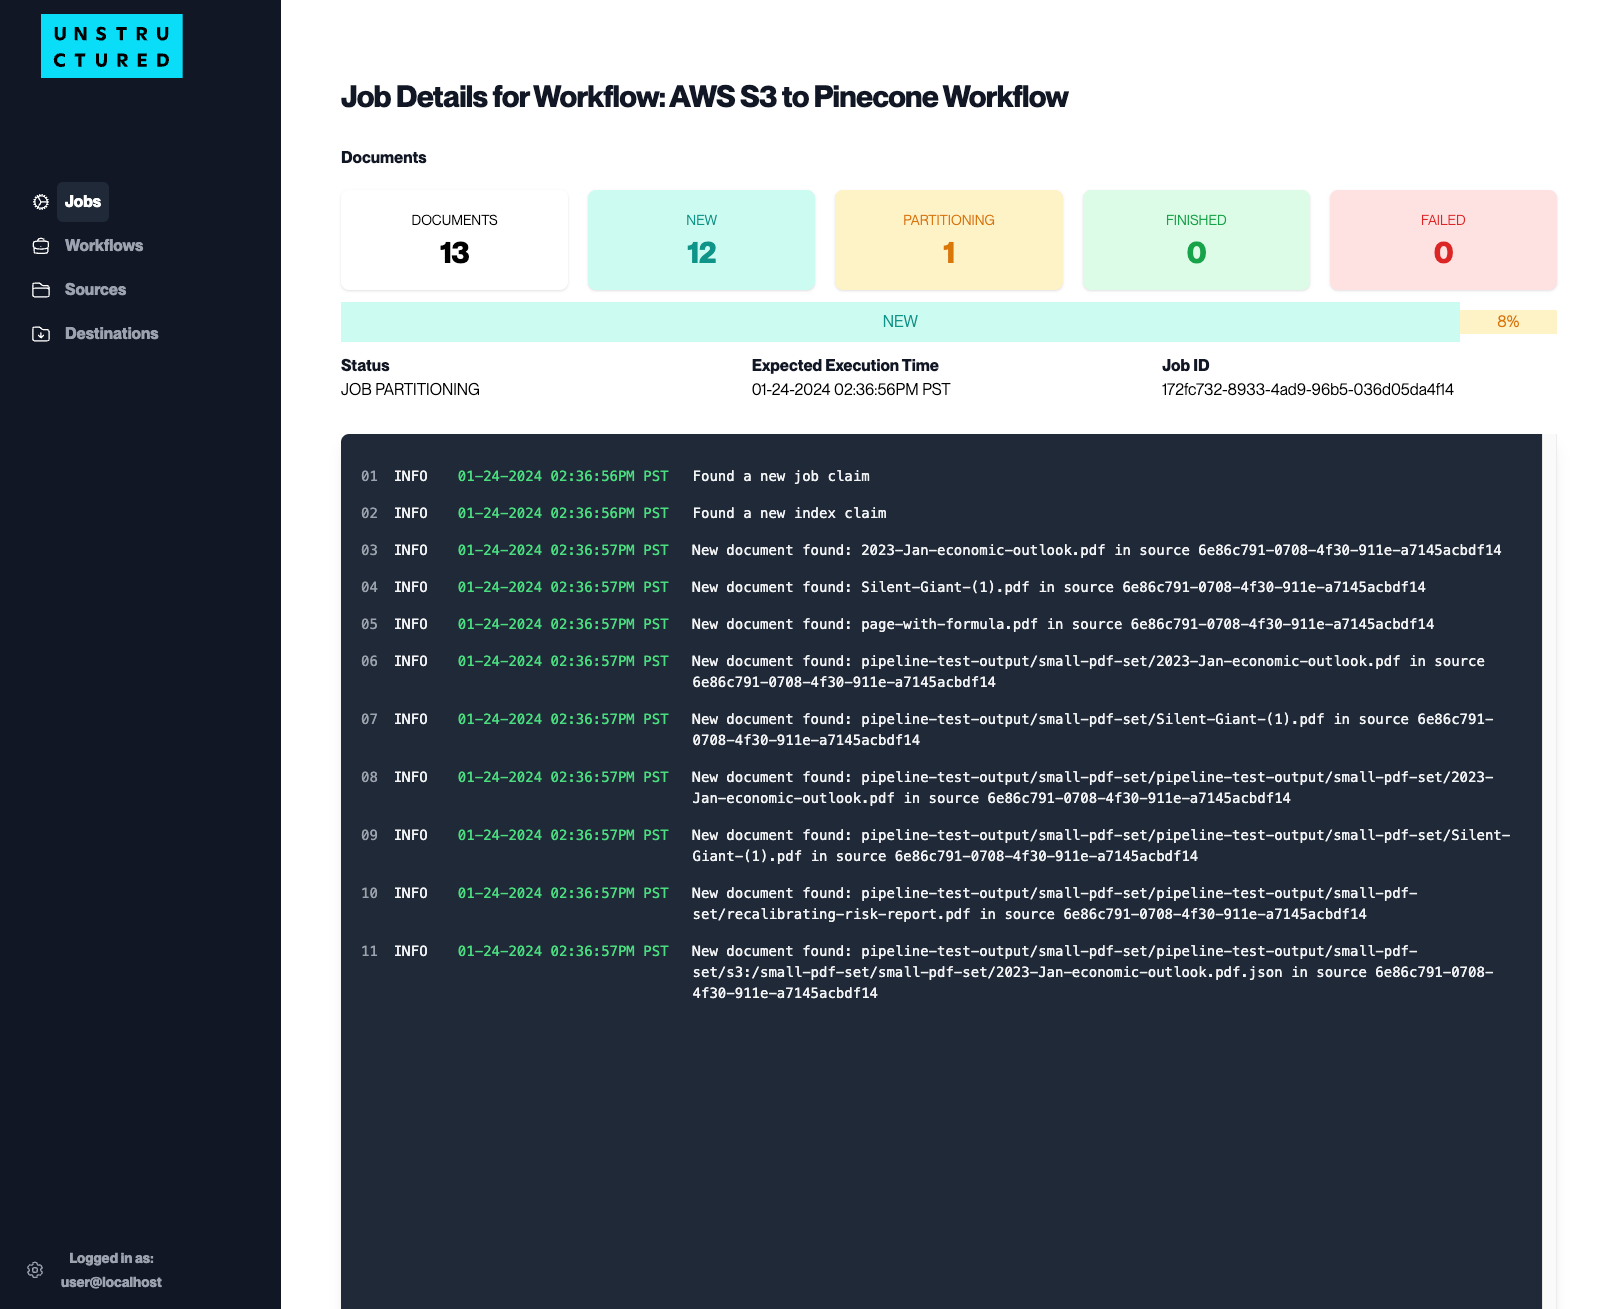
После Run перейдите в Jobs. Pending означает, что обработка ещё не выполняется, In Progress — работа идёт, Finished — завершение, Failed — существенная доля документов не обработана. Не ограничивайтесь цветом общего статуса: откройте конкретный Job и посмотрите детали по документам и сообщения выполнения. Найдите первый файл, на котором появилась проблема, затем проверьте его отдельно в локальном Test или небольшом временном source.
Для повторяемой эксплуатации сохраняйте рядом с pipeline три идентификатора: имя workflow, Job ID и версию конфигурации приложения. Это позволяет связать запись в destination с конкретным прогоном. При сбое не запускайте немедленно весь архив с Reprocess All: сначала исправьте причину на одном документе, затем повторите небольшой набор, и только после успешной проверки запускайте массовую обработку.
Типичные ошибки: как найти причину и проверить исправление
Большинство проблем удобно разделить на четыре слоя: доступ к source/destination, partitioning, chunking/enrichment и запись результата. Такое разделение экономит время: ошибка авторизации не лечится сменой OCR, а плохой порядок колонок не исправляется повторным подключением базы. Диагностику всегда начинайте с минимального воспроизводимого файла и одного ручного Job. После исправления повторяйте тот же эталон, а не другой документ.
Порядок диагностики от входного файла до destination
- Откройте Source connector и выполните Save and Test. Убедитесь, что тестовая папка видна и выбран правильный путь.
- Запустите тот же PDF как local file через Test. Если локальный результат корректен, проблема находится не в самом Partitioner, а дальше по потоку или в connector.
- Проверьте Partitioner на эталоне. Для open-source PDF не смешивайте облачные стратегии с локальными: local partition_pdf использует auto, hi_res, ocr_only и fast.
- Отключите дополнительные enrichments и Embedder и повторите обработку. Если базовый JSON появился, возвращайте узлы по одному.
- Проверьте chunking отдельно на сохранённых elements. Это позволяет менять размеры без повторного OCR и layout inference.
- В destination убедитесь, что схема, идентификатор, поля metadata и размерность вектора совместимы с тем, что отправляет workflow.
- После исправления выполните маленький Job, сверяйте число обработанных документов и несколько конкретных записей, затем запускайте весь набор.
Отдельная ловушка — неполная таблица при формально успешном Job. Для Fast и High Res в Pipelines доступен Infer Table Structure, который добавляет text_as_html к элементу таблицы. Если downstream ожидает HTML, но поле отсутствует, сначала проверьте стратегию и соответствующую настройку Partitioner. Для image/table summaries также проверьте совместимость стратегии с enrichment node. Нельзя диагностировать отсутствие поля как проблему базы, пока не подтверждено, что это поле вообще создаётся на этапе Transform/Enrich.
В PDF есть текст, но порядок колонок неправильный
Сравните Auto и другие подходящие стратегии на той же странице. В локальном partition_pdf для многостолбцового PDF без извлекаемого текста документация отдельно рекомендует проверить ocr_only, потому что hi_res способен ошибаться в порядке элементов.
После изменения chunking старые документы не изменились
Изменение workflow не запускает повторную обработку неизменённых файлов автоматически. На контролируемый прогон включите Reprocess All, проверьте обновление destination, затем верните нужный инкрементальный режим.
В destination появились дубли
Проверьте правило идентификатора и upsert в destination, а также переименования исходных файлов. Для workflow record ID зависит от имени и пути; переименование считается новым документом.
Таблица распознана как текст без структуры
Проверьте стратегию Partitioner и настройку Infer Table Structure. В Pipelines для совместимых стратегий таблица получает HTML-представление text_as_html; в локальной библиотеке извлечение table blocks требует hi_res.
Enrichment не создаёт описания изображений или таблиц
Сверьте совместимость с Partitioner. Fast такие описания не создаёт; Auto/High Res используют соответствующие enrichment nodes, а VLM обрабатывает поддерживаемые визуальные случаи по своей схеме.
Job падает только на части файлов
Откройте детали Job, найдите первый проблемный документ и повторите его отдельно через локальный Test. Затем проверьте формат, доступность содержимого, стратегию и конкретный узел, после которого перестаёт появляться ожидаемый результат.
После устранения ошибки выполните регрессионную проверку: один простой PDF, один сложный, один скан и один документ с таблицей. Сравните типы элементов, порядок чтения, число chunks и записи в destination с сохранённым эталоном. Исправление считается завершённым, когда проходит тот же набор, на котором ошибка воспроизводилась, и при этом не ломается базовый сценарий.
Плюсы, минусы, альтернативы и выбор сценария
Сильная сторона Unstructured — не один OCR-алгоритм, а связка ingestion, partitioning, chunking, enrichments, embeddings и destinations. Это удобно, когда команде нужен повторяемый путь от корпоративного хранилища до поискового индекса. Одновременно такая архитектура избыточна для задачи «открыть PDF и исправить текст» и требует дисциплины вокруг схемы данных, тестовых документов и повторной обработки.
Плюсы
- Единый визуальный workflow соединяет source, transform, chunking, enrichments, embedding и destination.
- Auto маршрутизирует PDF постранично между Fast, High Res и VLM на основе содержимого страницы.
- Канонический JSON сохраняет типы элементов и богатые metadata, а не только плоский текст.
- Есть широкий набор source и destination connectors, включая объектные хранилища, корпоративные сервисы, базы и vector databases.
- Open-source библиотека позволяет выполнять partitioning и chunking локально и отделять кодовый путь от managed Pipelines.
- Jobs, расписание и Reprocess All дают управляемую повторную обработку больших коллекций.
Минусы
- Unstructured не редактирует визуальное содержимое PDF: правки страниц, шрифтов и объектов выполняются другим классом программ.
- Качество зависит от класса документов, поэтому стратегию нельзя выбирать только по названию; необходим контрольный набор.
- Облачный Pipelines и open-source библиотека имеют различающийся набор стратегий и возможностей, их настройки нельзя механически переносить один в один.
- Сложные потоки добавляют зависимость от connectors, destination-схемы, embedding-модели и правил повторной индексации.
- Enrichments и overlap способны увеличивать объём результата и число дублей без пользы, когда downstream их не использует.
Кому подойдёт
- Командам, которые строят RAG, enterprise search или ingestion для аналитики из PDF, офисных документов, писем и изображений.
- Проектам, где важны типы элементов, страницы, координаты, таблицы, визуальные объекты и provenance.
- Инженерам, которым нужен и no-code конструктор, и локальная Python-библиотека для экспериментирования.
- Не подойдёт как замена PDF-редактору, простому просмотрщику или инструменту ручной корректировки страниц.
Чем отличаются MinerU, Mistral OCR и специализированный OCR
Выбор альтернативы зависит от того, какой слой вам нужен. MinerU ориентирован на извлечение данных из PDF и подходит для сравнения, когда основной результат — структурированное представление самого документа. Mistral OCR относится к сервисам распознавания документов и полезен как альтернатива, когда ядром задачи является OCR. Unstructured отличается тем, что объединяет извлечение с connectors, chunking, enrichments, embeddings и записью в destination в одном pipeline.
Практическая рекомендация для трёх типовых проектов
Для прототипа RAG начните с одного PDF в local Test, Auto и By Title; сохраните JSON и проверьте пять–десять реальных вопросов. Для корпоративного архива сначала создайте маленькую source-папку, source/destination connectors и один ручной Job, затем настройте Reprocess All и расписание. Для локального контура начните с Python partition_pdf, сохраните elements, отдельно настройте chunking и только после этого подключайте собственную индексацию. Во всех трёх случаях двигайтесь от эталона к масштабу, а не наоборот.
Если документы в основном состоят из чистого текста, не усложняйте поток визуальными enrichment-узлами. Если ценность находится в таблицах, графиках и сложном layout, уделите больше времени Partitioner и проверке структурных полей. Если данные быстро меняются, основной риск лежит не в OCR, а в корректной инкрементальной переобработке и upsert. Unstructured полезен тогда, когда эти этапы рассматриваются как единая инженерная цепочка, а не как разовая конвертация PDF.