Telerik Document Processing — не настольный редактор, а набор UI-независимых .NET-библиотек для программной работы с PDF, Word-подобными и табличными документами. На странице Xeon Live можно скачать Telerik Document Processing бесплатно для ознакомления с карточкой продукта и перейти к подходящему варианту получения пакетов. В реальном проекте работа идёт через NuGet, объектные модели документов, редакторы и провайдеры форматов.
Главное достоинство такого подхода — воспроизводимость: один и тот же код создаёт документы на сервере, в десктопном приложении, веб-сервисе или облачном задании без запуска Microsoft Office или Adobe Acrobat. Главный компромисс тоже принципиален: собственного визуального редактора у Telerik Document Processing нет, поэтому пользователю библиотеки нужны C#/.NET, тестовые документы и обычные инструменты разработки.
Что такое Telerik Document Processing и для каких задач он нужен
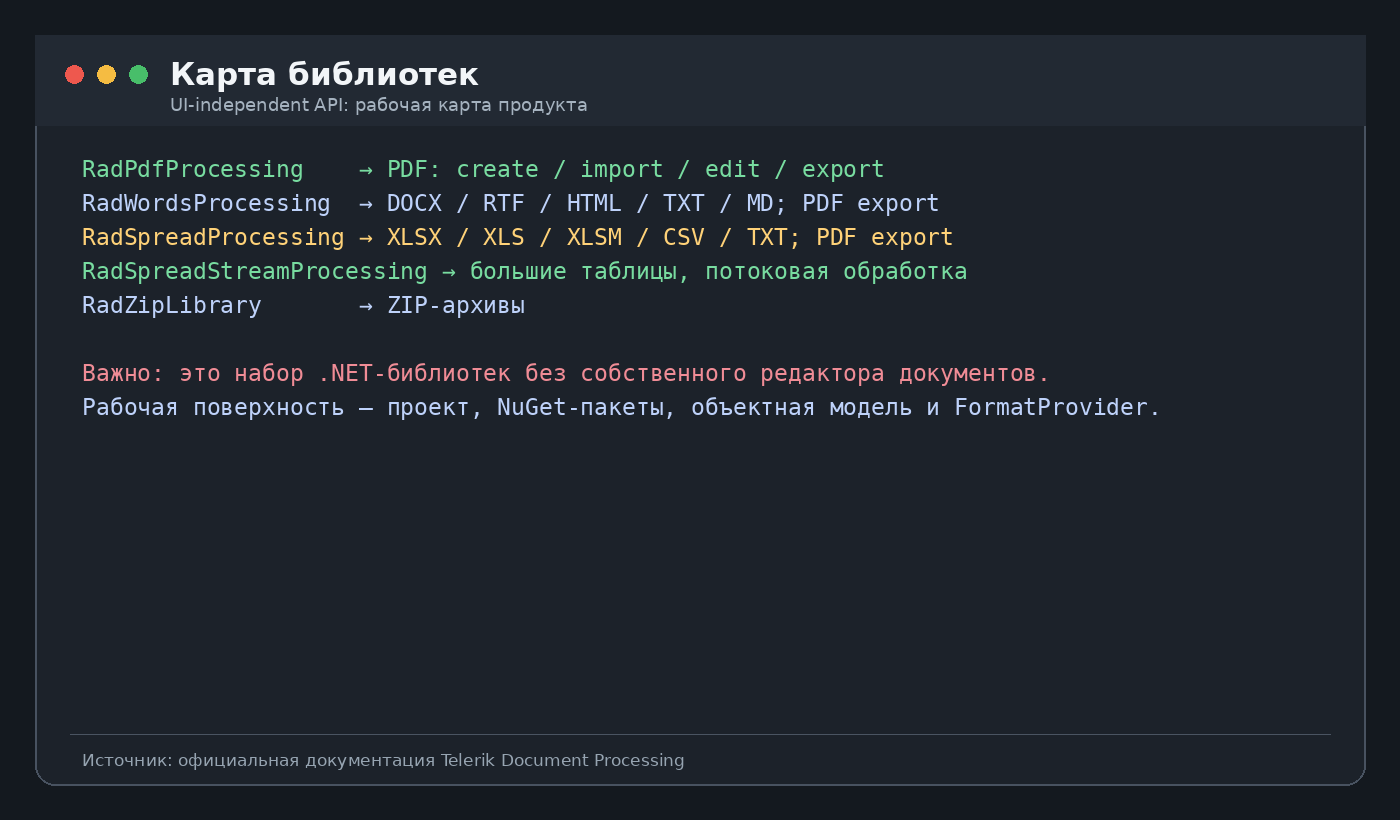
Комплект объединяет несколько библиотек с разными моделями данных. RadPdfProcessing работает с фиксированной PDF-моделью; RadWordsProcessing — с потоковыми документами наподобие Word; RadSpreadProcessing — с книгами и листами Excel; RadSpreadStreamProcessing рассчитан на большие таблицы и потоковую обработку; RadZipLibrary закрывает работу с ZIP. Это важнее маркетингового перечисления форматов: правильный выбор библиотеки определяет доступные операции и способ управления памятью.
Форматы и реальные границы конвертации
Источник: Telerik Document Processing documentation
RadWordsProcessing импортирует и экспортирует DOCX, RTF, HTML и TXT, умеет импортировать DOC и DOT и экспортировать потоковый документ в PDF. В актуальной документации также заявлен Markdown. RadSpreadProcessing работает с XLSX, XLS, XLSM, CSV и TXT; PDF для таблиц является направлением экспорта, а JSON — экспортным форматом. В XLSM макросы сохраняются при чтении и записи, но библиотека не исполняет и не редактирует VBA-код.
Сочетание слов PDF, Word и Excel не означает универсальную двунаправленную конвертацию любого документа во все остальные форматы. Например, произвольный PDF не превращается штатным RadPdfProcessing в семантически восстановленный DOCX или XLSX: библиотека ориентирована на PDF-модель и умеет, в частности, извлекать текст. Для сценариев конвертации между форматами сначала сверяют конкретный FormatProvider и его направление. Для общего понимания устройства PDF полезен материал Xeon Live о формате PDF, редактировании и конвертации.
Кому подходит библиотека
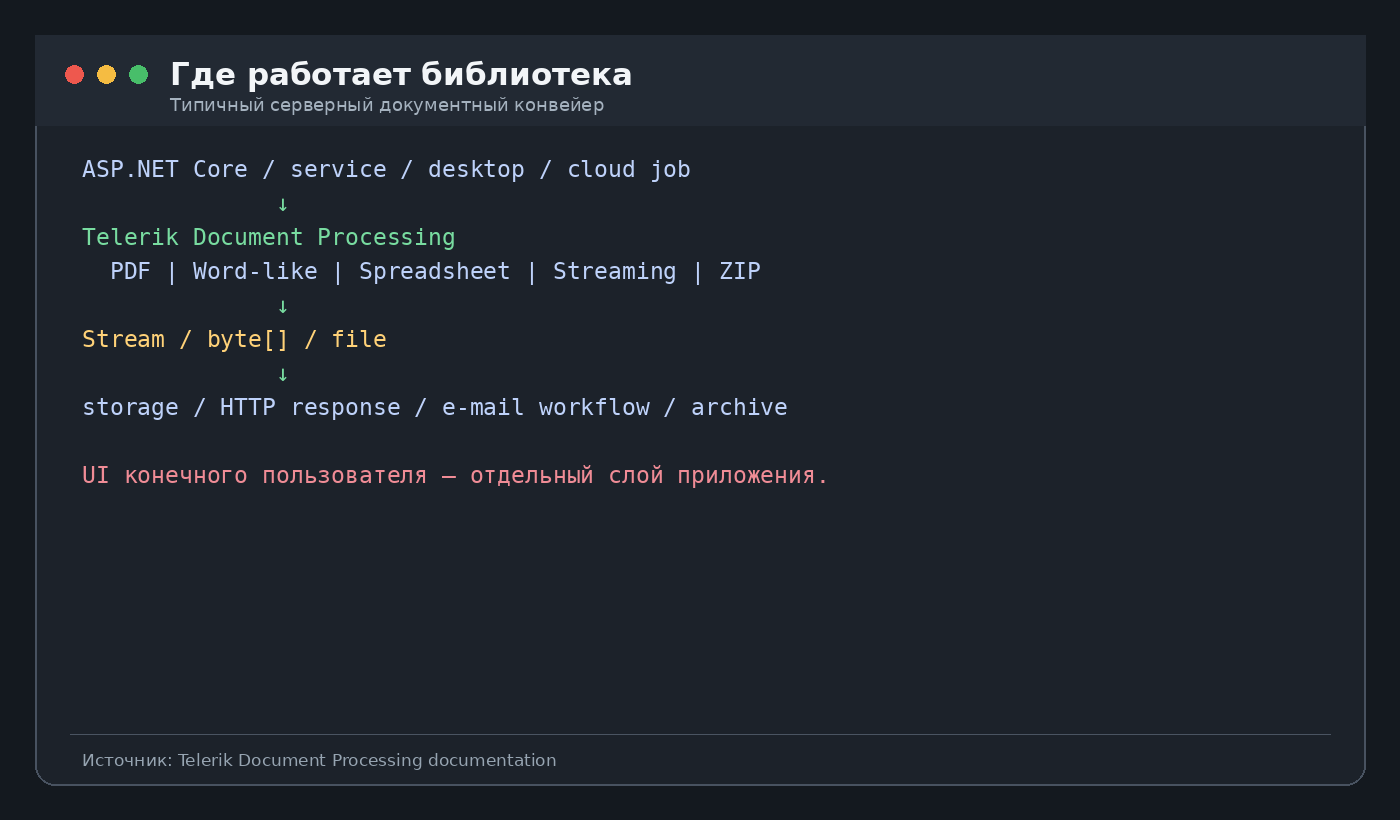
Telerik Document Processing подходит разработчикам backend-сервисов, корпоративных систем, личных кабинетов, отчётности, документооборота и автоматизации, где документы формируются или преобразуются без ручной работы оператора. Он также уместен в desktop- и web-приложениях, где собственный интерфейс уже существует, а обработка файлов должна жить в сервисном слое. Для сотрудника, которому требуется открыть PDF мышью и исправить пару строк без кода, набор не подходит: нужен готовый редактор или UI-компонент поверх библиотек.
Рабочая карта вместо обычного интерфейса
У продукта нет окна с лентой, панелью инструментов и кнопкой «Открыть». Практическая карта выглядит иначе: пакеты проекта → модель документа → редактор → FormatProvider → Stream или byte[] → проверка результата. Именно эти точки заменяют привычные области интерфейса. Настройки находятся в свойствах редакторов, document model, ImportSettings и ExportSettings, а команды представлены методами API.
Как выбрать редактор документа
Источник: Telerik Document Processing documentation
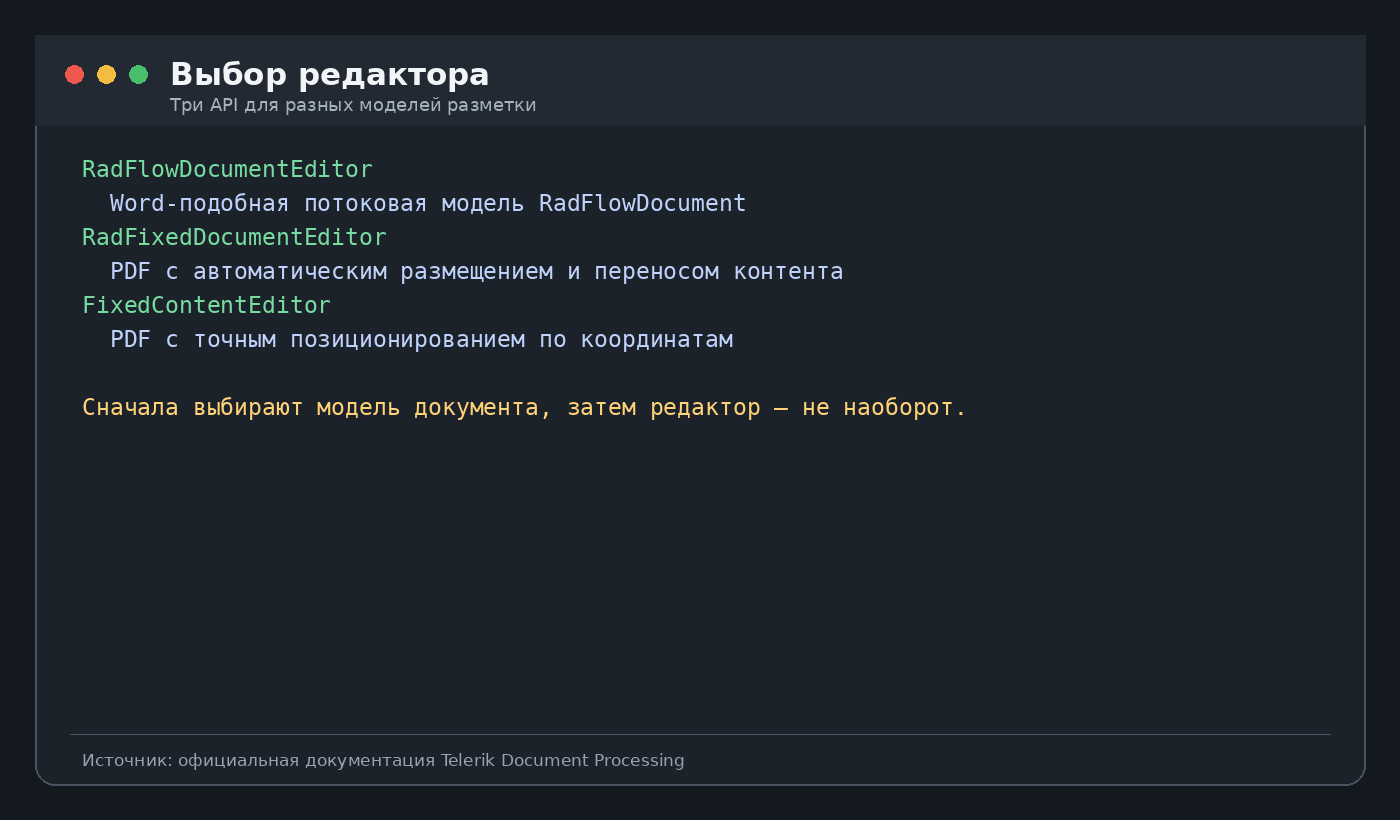
RadFlowDocumentEditor используют в RadWordsProcessing для логического потока абзацев, секций, таблиц, полей и изображений. RadFixedDocumentEditor работает с PDF и помогает раскладывать последовательный контент с меньшим количеством ручных вычислений. FixedContentEditor даёт низкоуровневый контроль над положением элементов на конкретной PDF-странице. Ошибка выбора проявляется быстро: либо приходится вручную считать координаты для длинного отчёта, либо не хватает точности для штампа, формы или оверлея.
Где находятся настройки импорта и экспорта
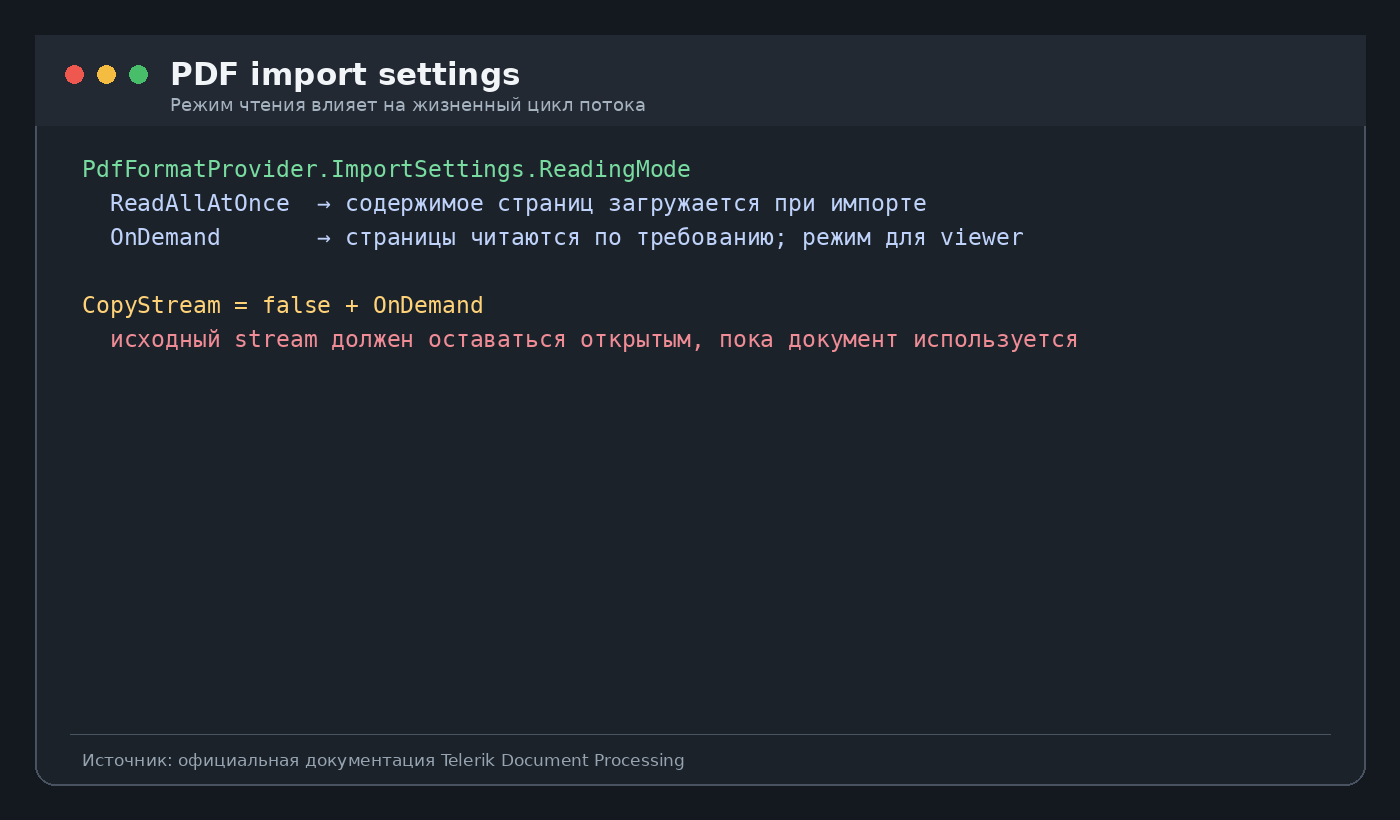
Импорт и экспорт выполняют классы-провайдеры: PdfFormatProvider, DocxFormatProvider, RtfFormatProvider, HtmlFormatProvider, XlsxFormatProvider и другие. У PDF-провайдера есть ImportSettings и ExportSettings; для PDF можно настраивать чтение, шифрование, качество изображений, внедрение шрифтов и другие параметры. В таблицах отдельные провайдеры соответствуют XLSX, XLS, CSV, TXT и PDF. Такой подход позволяет хранить настройки рядом с кодом конвейера и покрывать их тестами.
Источник: Telerik Document Processing documentation
Как добавить библиотеку и создать первый PDF
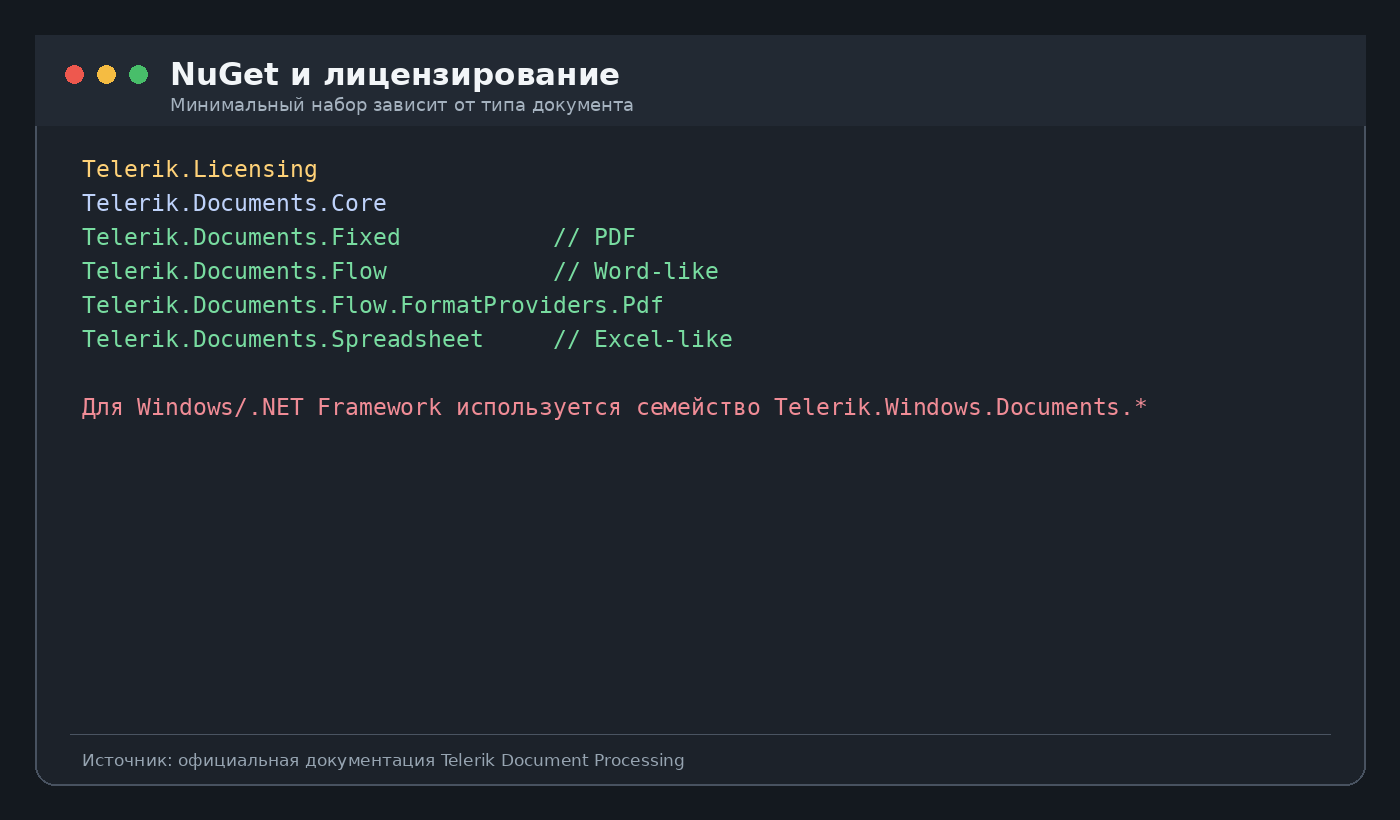
Первый рабочий сценарий стоит делать минимальным: один проект, один тип документа, один выходной файл. Так проще отделить ошибки пакетов и лицензии от ошибок разметки. Для кроссплатформенного современного .NET используется семейство Telerik.Documents.*, а для Windows-ориентированных проектов и .NET Framework — Telerik.Windows.Documents.*. Все пакеты одного семейства держат на согласованной версии.
Шаг 1. Добавить пакеты и активировать лицензию
Источник: Telerik Document Processing documentation
- Определите целевой сценарий. Для PDF добавьте Telerik.Licensing, Core и Fixed; для Word — Core и Flow; для Word → PDF добавьте Flow.FormatProviders.Pdf; для Excel — Spreadsheet, а PDF-экспорт таблиц требует соответствующего PDF-провайдера.
- Не смешивайте семейства. В кроссплатформенном проекте используйте Telerik.Documents.*, в Windows/.NET Framework — Telerik.Windows.Documents.*. Случайная смесь пространств имён усложняет зависимости и переносимость.
- Настройте лицензию. Актуальные версии используют Telerik.Licensing и файл telerik-license.txt либо переменную среды TELERIK_LICENSE. В CI/CD секрет передают через защищённое хранилище, а не коммитят в репозиторий.
- Соберите проект до написания логики документа. На этом этапе в логе не должно оставаться ошибок активации, конфликтов пакетов и отсутствующих assembly. Такой контроль экономит время при последующей отладке экспорта.
Для новых проектов пакеты устанавливают из NuGet.org; они также входят в соответствующие Telerik-продукты и DevCraft. Коммерческое использование регулируется лицензией пакета, а для знакомства доступен trial. Поэтому «скачивание программы» здесь фактически означает добавление библиотек в .NET-проект и настройку лицензии, а не установку отдельного EXE.
Шаг 2. Создать RadFixedDocument и страницу
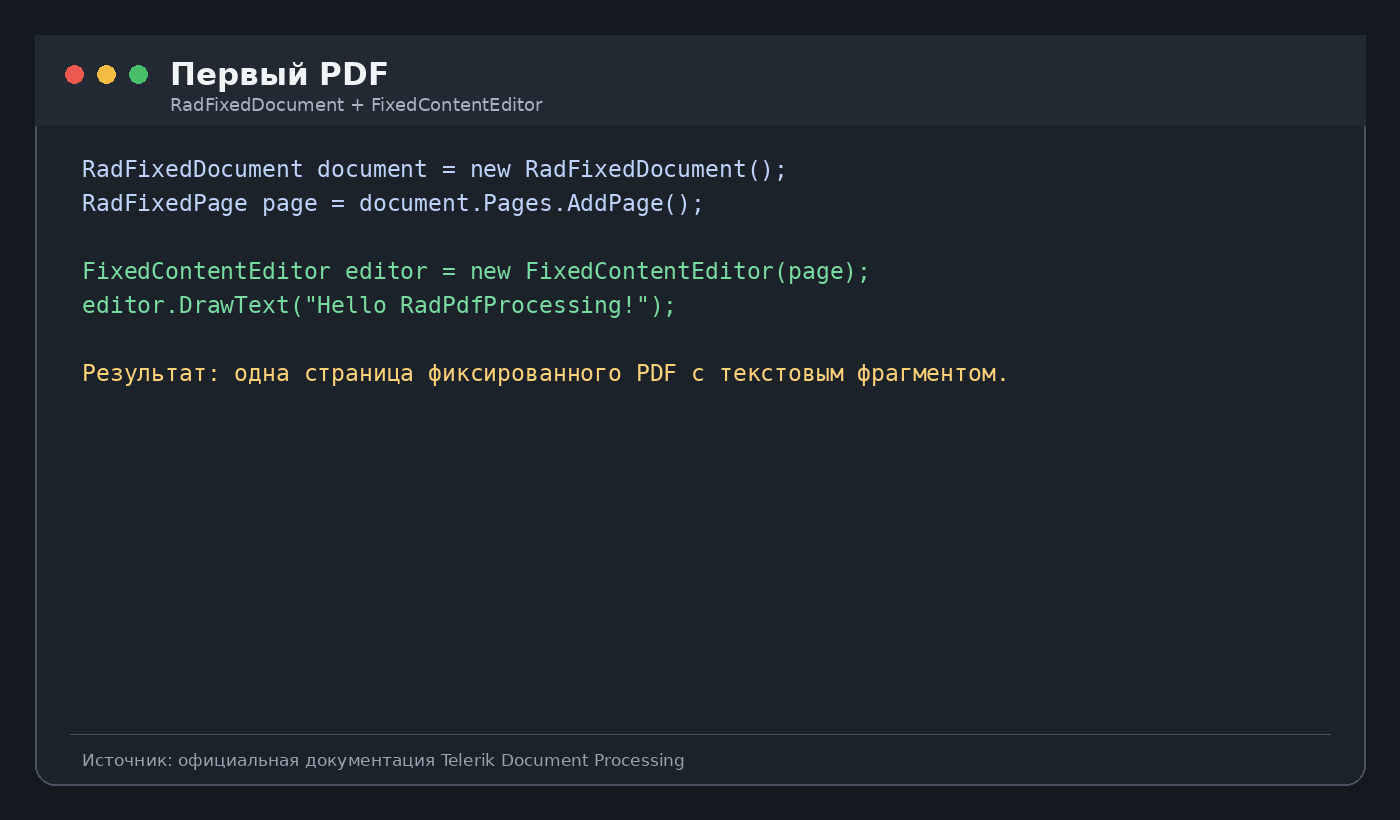
В простейшем PDF корневой объект — RadFixedDocument. Создайте его, добавьте RadFixedPage через document.Pages.AddPage(), затем передайте страницу в FixedContentEditor. Вызов editor.DrawText() размещает текст на странице. Для длинных отчётов вместо ручного позиционирования сразу выбирают RadFixedDocumentEditor: он лучше соответствует последовательной вставке блоков и снижает риск наложений.
Источник: Telerik Document Processing documentation
- Создайте новый RadFixedDocument и добавьте одну страницу.
- Создайте FixedContentEditor для этой страницы. Для точного макета заранее задайте размер страницы и координаты; для потокового отчёта используйте RadFixedDocumentEditor.
- Вставьте минимальный текст и только после этого добавляйте изображения, таблицы, формы и сложную графику.
- Сохраните первый результат и откройте его обычным PDF-просмотрщиком. Проверяйте не только наличие файла, но и фактический текст, размер страницы и отсутствие обрезания.
Шаг 3. Экспортировать и проверить PDF
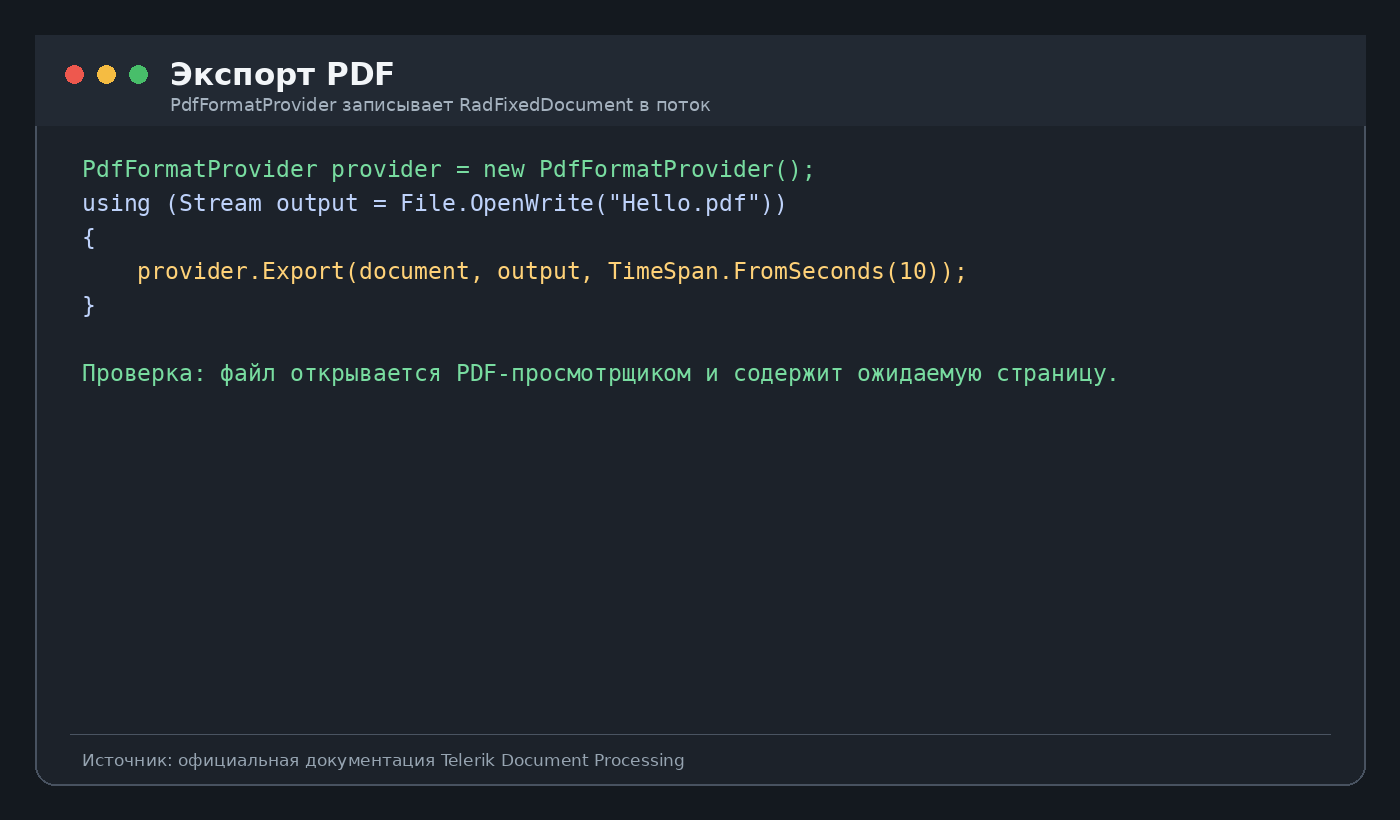
Для записи RadFixedDocument используется PdfFormatProvider. Создайте выходной Stream, вызовите Export и передайте тайм-аут, предусмотренный текущим API. В серверном приложении тем же способом можно экспортировать в MemoryStream или byte[] и затем вернуть файл клиенту. Не привязывайте документный слой к конкретному HTTP-фреймворку: библиотека работает с потоками, а формирование HTTP-ответа остаётся задачей приложения.
Источник: Telerik Document Processing documentation
После экспорта выполняйте автоматическую проверку: поток не пуст, размер больше нуля, повторный импорт PdfFormatProvider проходит без исключения, число страниц совпадает с ожидаемым. Для бизнес-документов дополнительно проверяют контрольные фразы, метаданные и наличие обязательных закладок или полей. Визуальную регрессию полезно вести на нескольких эталонных документах, особенно после обновления пакетов.
Как обрабатывать Word-подобные документы и получать PDF
RadWordsProcessing строится вокруг RadFlowDocument. Эта модель удобна там, где важна логическая структура: секции, абзацы, runs, таблицы, поля, списки, стили, колонтитулы. Для массовой генерации договоров, актов, писем и отчётов это обычно более естественная отправная точка, чем рисование PDF по координатам.
Шаг 1. Импортировать шаблон или собрать документ с нуля
Источник: Telerik Document Processing documentation
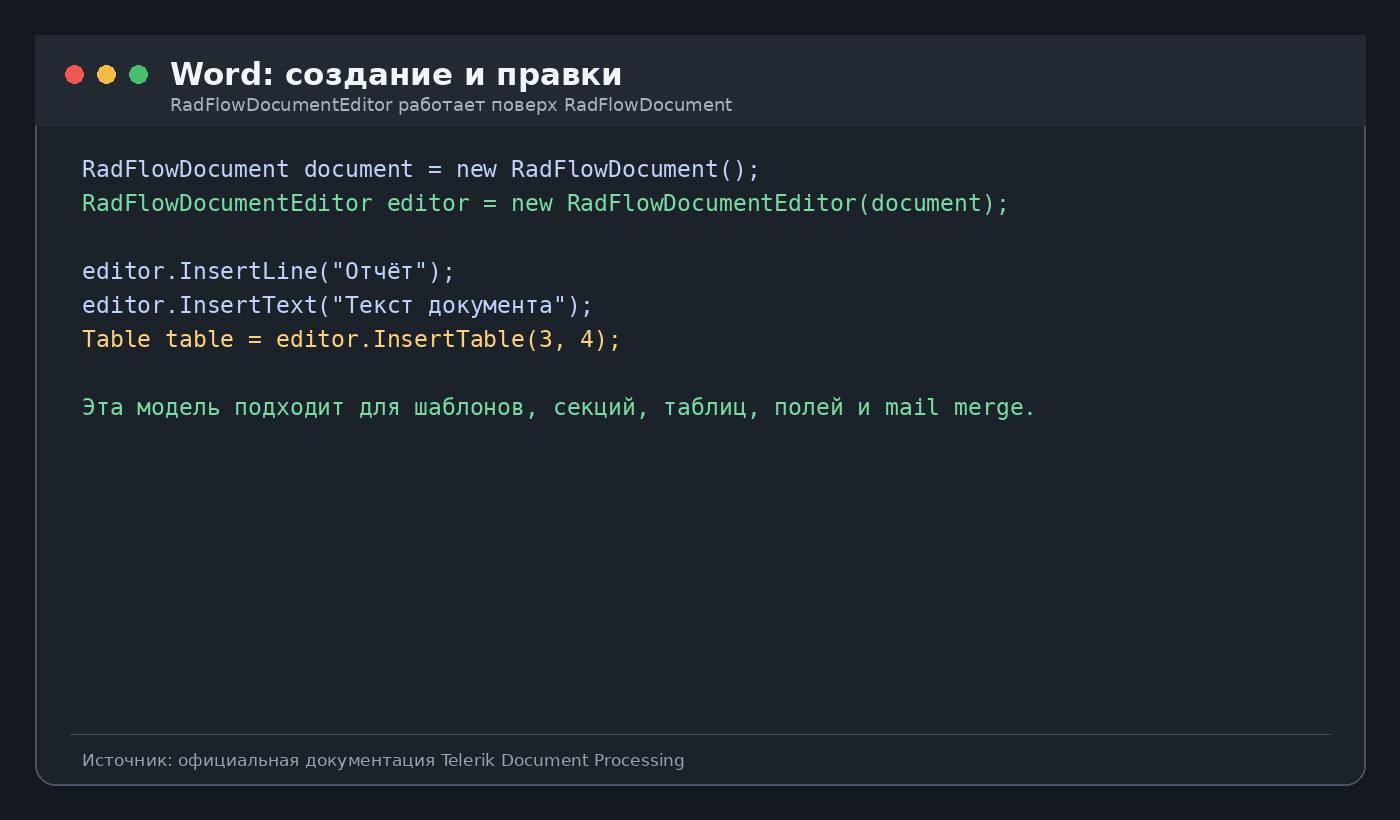
Для существующего DOCX используйте DocxFormatProvider и импортируйте входной Stream в RadFlowDocument. Для старых DOC/DOT применяется DocFormatProvider, причём этот формат указан как import-only. Для нового документа создайте RadFlowDocument, затем RadFlowDocumentEditor и вставляйте элементы в логическом порядке. Editor поддерживает текст, абзацы, таблицы, изображения, гиперссылки и другие элементы модели.
- Откройте входной файл только на чтение и выберите FormatProvider по реальному расширению и содержимому.
- Импортируйте документ в RadFlowDocument и сразу проверьте число секций, наличие ожидаемых таблиц, полей и контрольных текстовых маркеров.
- Создайте RadFlowDocumentEditor поверх импортированной модели. Перемещайте позицию редактора к нужному абзацу или элементу и выполняйте изменения через API.
- Для шаблонной генерации храните в исходном DOCX стили и структуру, а данные подставляйте через mail merge, content controls или собственные маркеры. Это устойчивее, чем повторять вручную каждое свойство форматирования в коде.
Шаг 2. Замена текста, таблицы и mail merge
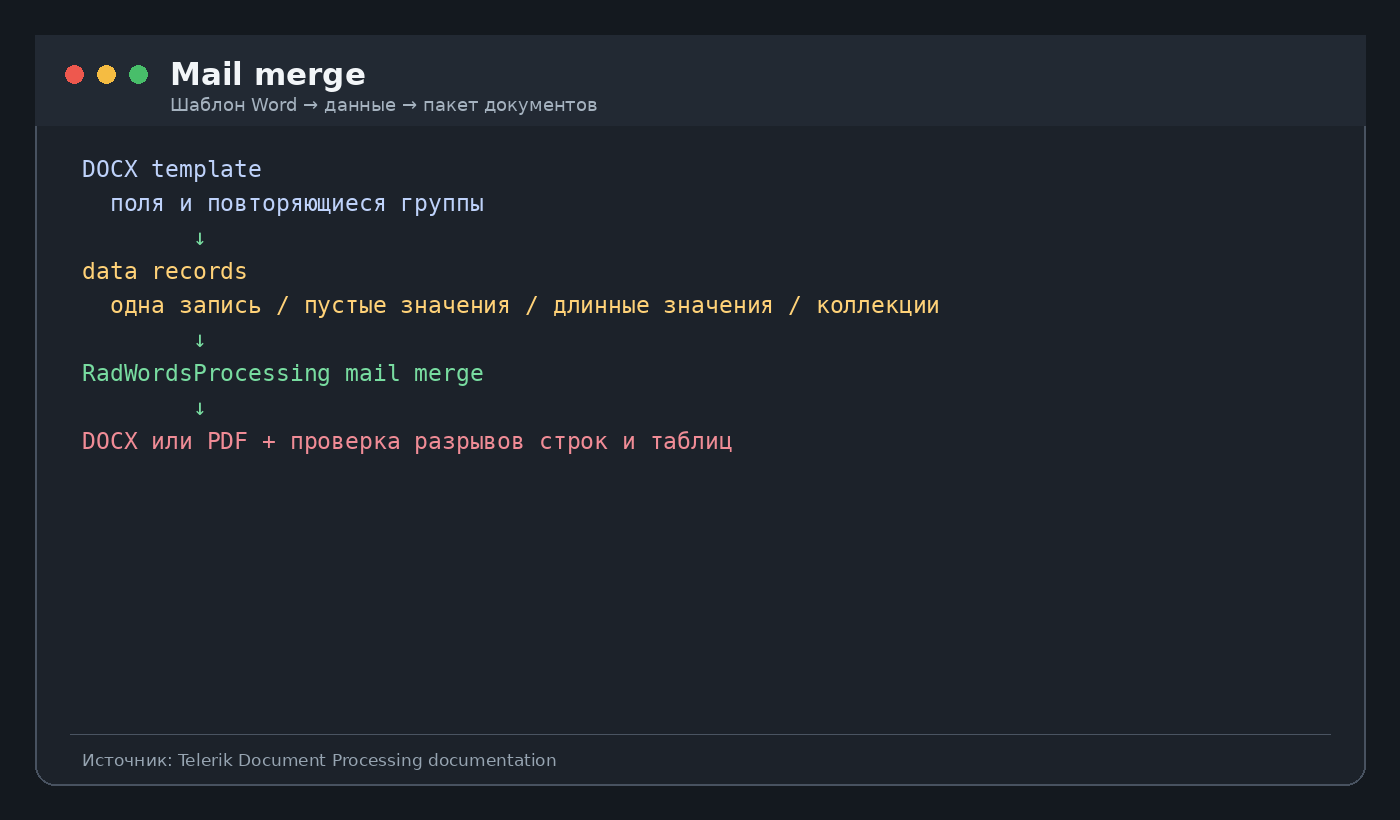
Для точечных правок используйте функции поиска и замены RadWordsProcessing. Перед заменой решите, должна ли операция менять только текст или ещё форматирование найденных фрагментов. Для персонализированных пакетов документов применяйте mail merge: один шаблон соединяется с коллекцией записей, а на выходе формируются заполненные документы. Вложенные группы и повторяющиеся таблицы требуют отдельного тестового набора данных, потому что именно там чаще проявляются ошибки структуры шаблона.
Практический порядок таков: импортируйте шаблон; проверьте имена полей; подайте тестовую запись с максимально длинными значениями; выполните слияние; убедитесь, что таблицы не выходят за поля страницы; затем прогоните набор с пустыми значениями и несколькими строками данных. Такой тест ловит разрывы строк, пустые ячейки и неожиданные переносы до того, как документ попадёт пользователю.
Шаг 3. Экспортировать DOCX, RTF, HTML, TXT или PDF
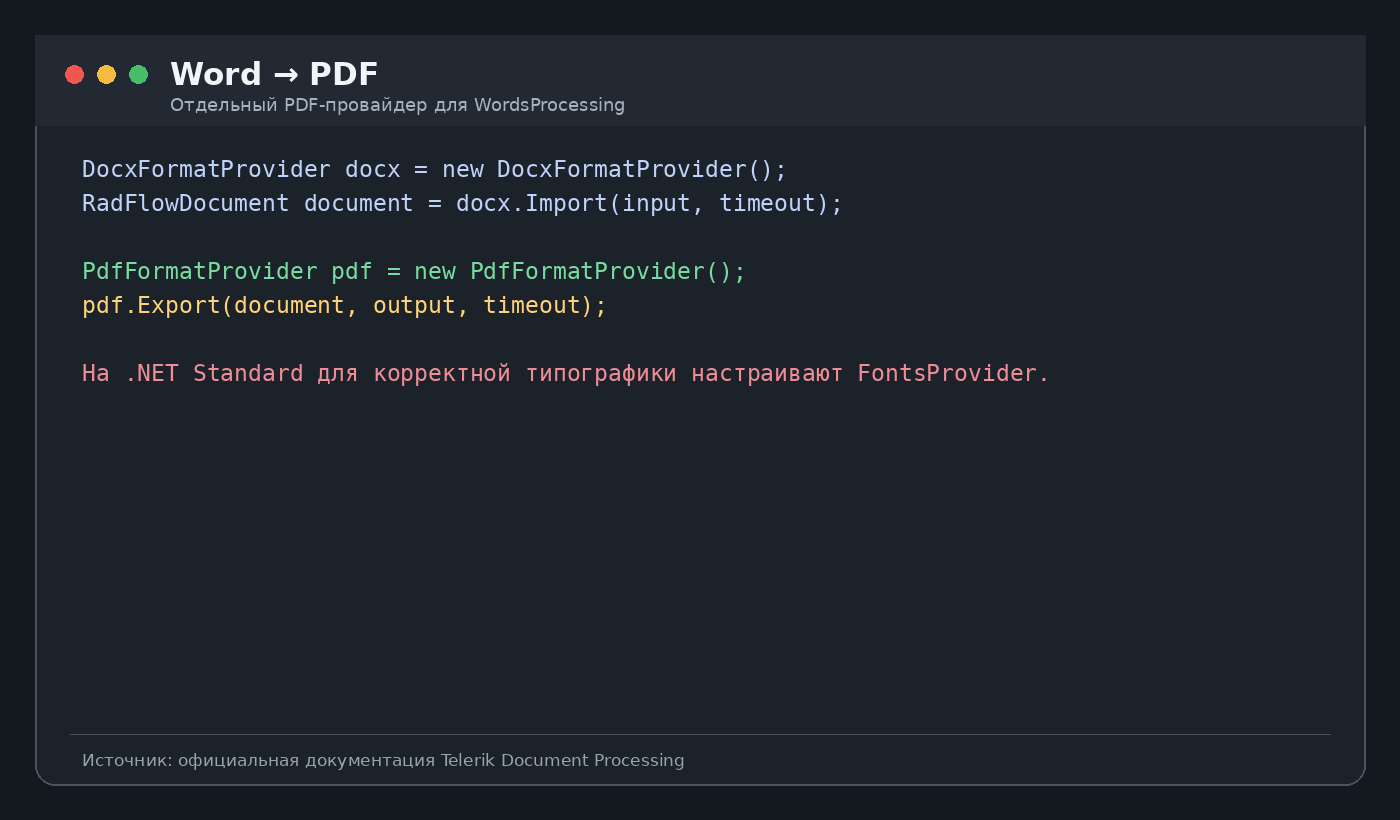
Для сохранения обратно в DOCX используйте DocxFormatProvider; для RTF, HTML и TXT — соответствующие провайдеры. PDF формируется отдельным PdfFormatProvider из пространства WordsProcessing. Это не тот же сценарий, что нативное редактирование PDF в RadPdfProcessing: исходная модель остаётся потоковой, а PDF создаётся как финальное фиксированное представление.
Источник: Telerik Document Processing documentation
На кроссплатформенном .NET особое внимание уделяйте шрифтам. PDF-провайдеру нужны реальные данные шрифтов, поэтому приложение предоставляет реализацию FontsProviderBase через FixedExtensibilityManager. Без этого результат может отличаться по переносам, метрикам и доступным глифам. После настройки прогоните документы с кириллицей, латиницей, цифрами, жирным и курсивным начертанием. Отдельный материал Xeon Live о конвертации Word в PDF помогает оценить типичные визуальные проблемы уже на уровне готового файла.
Как создавать и преобразовывать Excel-файлы
RadSpreadProcessing предоставляет полноценную объектную модель Workbook. Она нужна, когда код должен читать существующие книги, менять значения, формулы и форматирование, управлять листами, шириной столбцов, сортировкой, фильтрами, validation и параметрами печати. Для потоковой генерации очень больших таблиц используется отдельный RadSpreadStreamProcessing.
Шаг 1. Создать Workbook и заполнить данные
Источник: Telerik Document Processing documentation
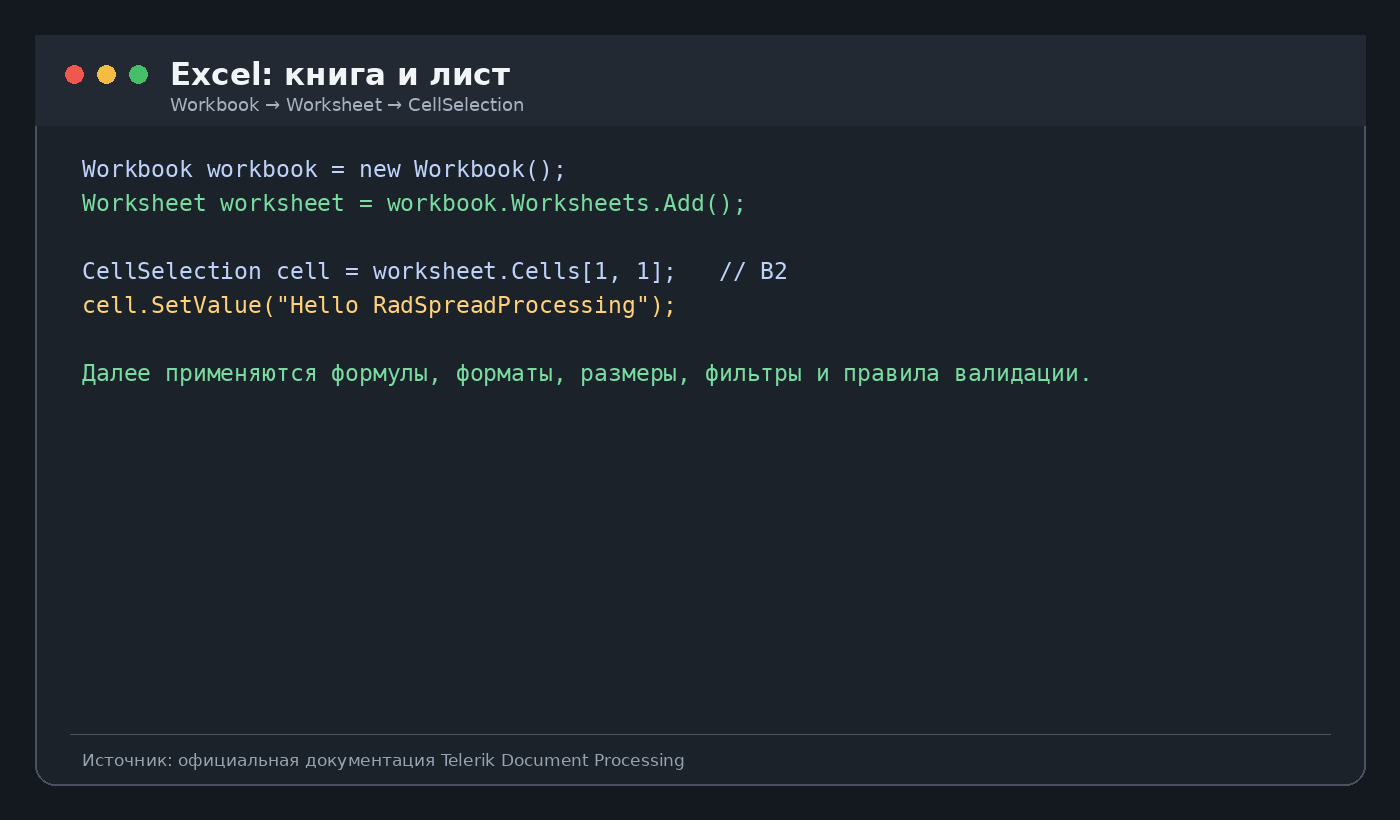
Создайте Workbook, добавьте Worksheet и получите нужный диапазон через worksheet.Cells. Присваивайте значения после того, как определили схему данных: заголовки, типы колонок, формулы и формат чисел. Не записывайте даты и денежные значения как отформатированные строки без необходимости — лучше хранить типизированные значения и задавать NumberFormat, чтобы Excel мог сортировать и вычислять их как числа.
- Создайте Workbook и один Worksheet; задайте имя листа, понятное пользователю.
- Запишите заголовки в первую строку, затем данные. Для формул используйте формульные значения модели, а не заранее рассчитанный текст там, где итог должен пересчитываться в Excel.
- Настройте ширину колонок, перенос текста, числовые форматы и заморозку областей только после заполнения основной структуры.
- Добавьте data validation, сортировку или фильтр там, где это является частью сценария, а не декоративной функцией.
- Перед экспортом проверьте количество листов, заполненный диапазон и несколько контрольных ячеек.
Шаг 2. Импортировать существующий XLSX и сохранить результат
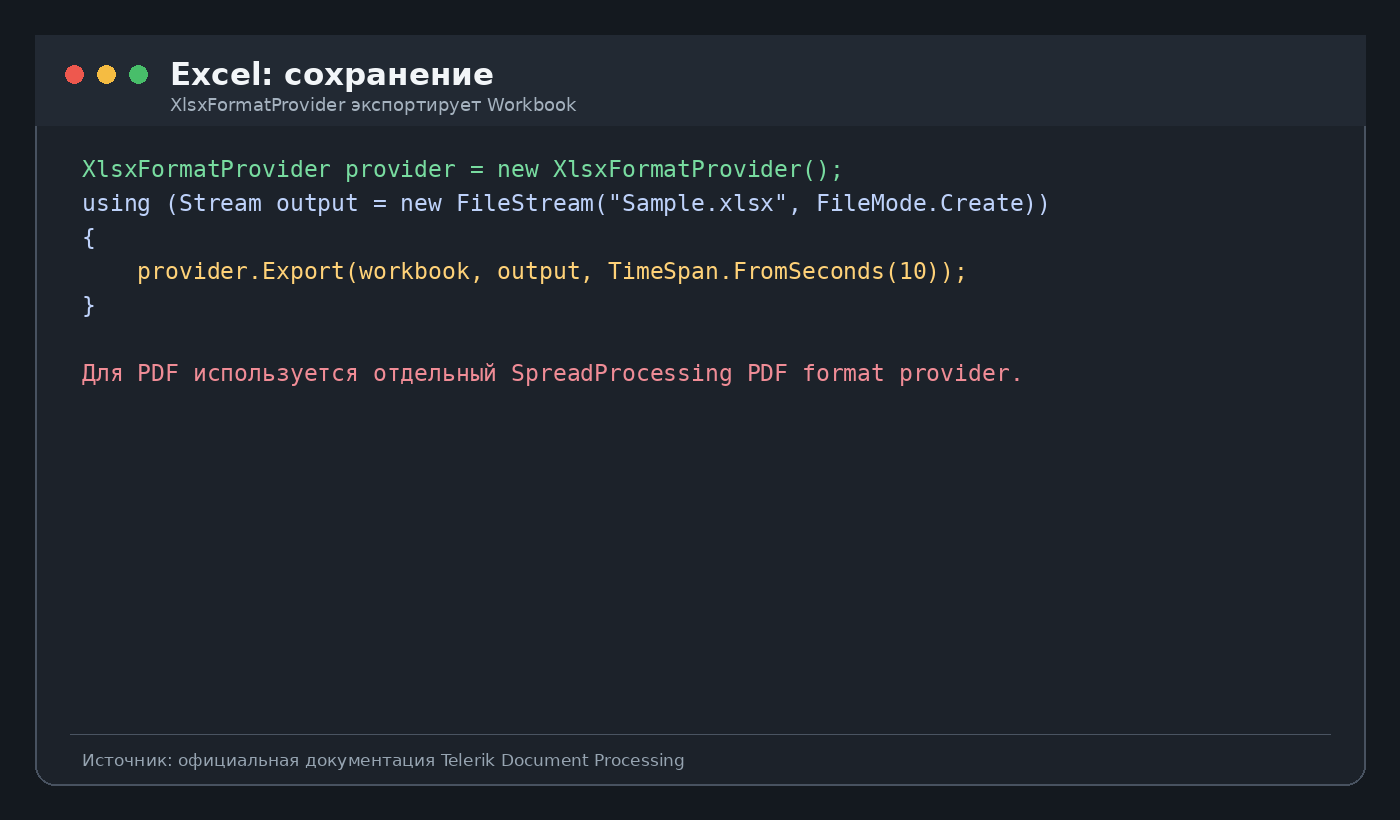
Для XLSX используйте XlsxFormatProvider. Импорт принимает Stream или byte[] и возвращает Workbook; после этого книга редактируется через ту же модель, что и созданная с нуля. Экспорт записывает Workbook обратно в поток. Для XLS применяется XlsFormatProvider, для CSV и TXT — соответствующие текстовые провайдеры. Поддержка XLSM рассчитана на сохранение макросов при импорте и экспорте, но код библиотеки не выполняет VBA и не изменяет макросы.
Источник: Telerik Document Processing documentation
Для контроля результата повторно импортируйте экспортированный XLSX и сравните контрольные значения, формулы и количество листов. В задачах отчётности полезно открыть файл также в целевой версии Excel или совместимом просмотрщике и проверить печатные области, переносы, ширину колонок и визуализацию формул. Это особенно важно, когда книга затем уходит в PDF.
Шаг 3. Перейти на потоковую обработку для больших файлов
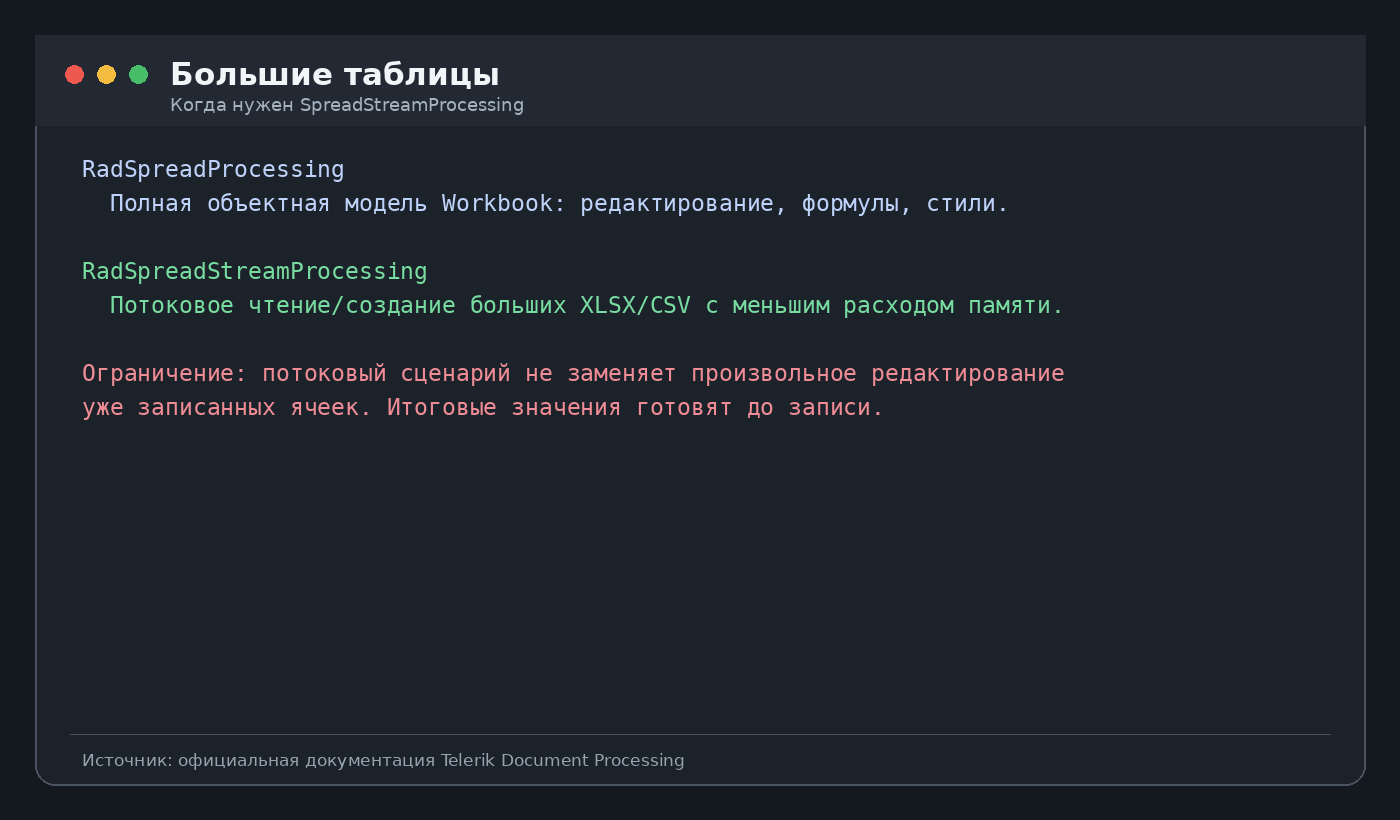
Когда полная объектная модель Workbook расходует слишком много памяти, RadSpreadStreamProcessing пишет и читает данные последовательно. Такой режим особенно полезен для больших выгрузок XLSX и CSV. Плата за экономию памяти — ограничения потоковой модели: уже записанную часть документа нельзя свободно переигрывать как обычный Workbook. Поэтому итоговые значения, порядок колонок и форматирование строки готовят до её записи.
Источник: Telerik Document Processing documentation
Практический переход выполняют после измерения. Сначала замерьте размер исходной выборки, пиковую память и время экспорта обычного Workbook. Затем перенесите массовую строковую часть в streaming API и повторите замеры на том же наборе. Если отчёт содержит сложную шапку, диаграммы или форматирование, оставьте такие части в полной модели, а объёмные данные формируйте потоково. В статье про PDF и Excel стоит учитывать обратную сторону задачи: извлечение табличной структуры из готового PDF — отдельная проблема и не равно штатному XLSX-экспорту RadSpreadProcessing.
Продвинутые PDF-сценарии: объединение, формы, подписи и производительность
После базовой генерации чаще всего нужны операции с уже существующими PDF. Здесь важно различать полную модель RadFixedDocument и потоковый PdfStreamWriter. Первая подходит для чтения и модификации содержимого, вторая — для быстрых операций со страницами, когда существующий контент можно переносить без детального разбора.
Как объединить или разделить PDF без лишней нагрузки на память
Источник: Telerik Document Processing documentation
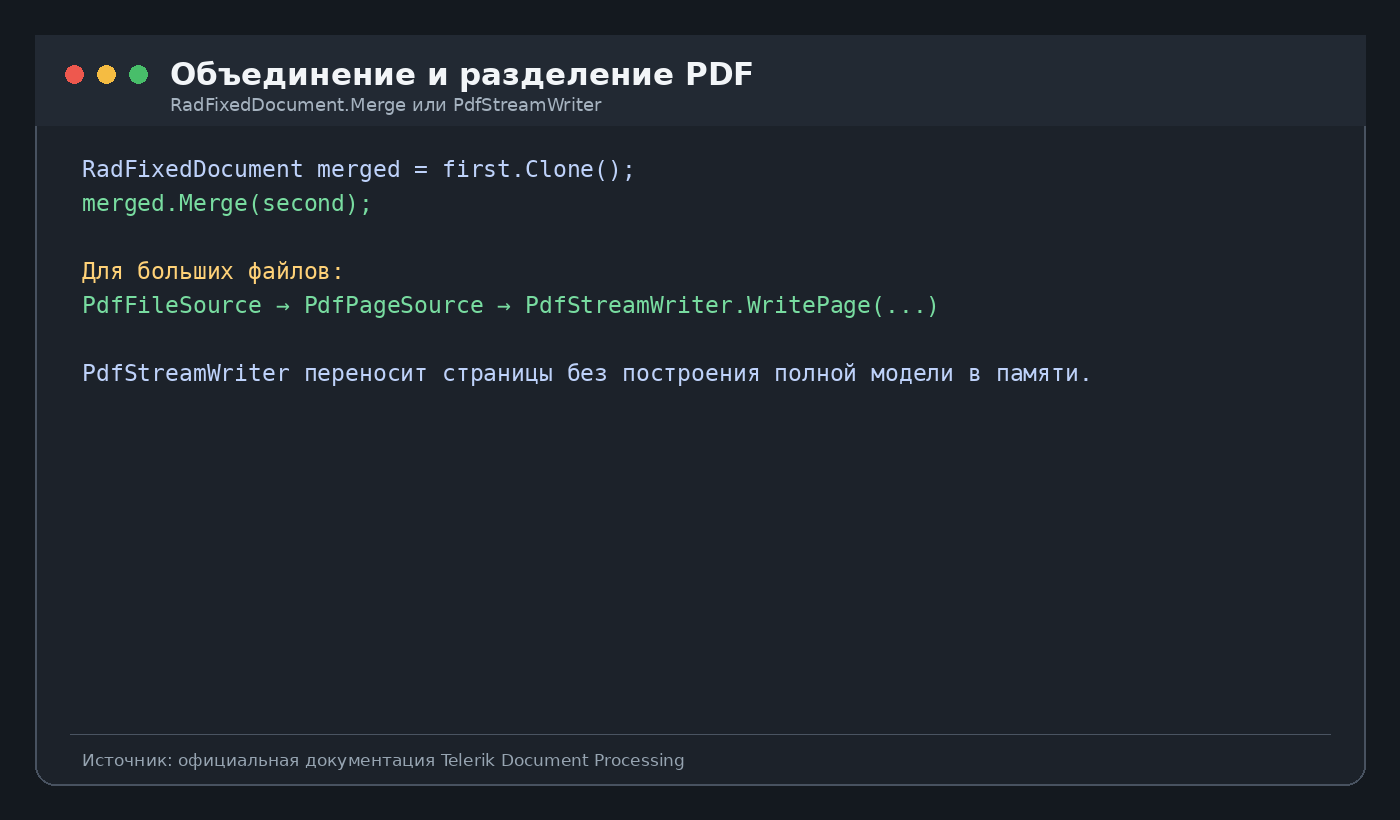
Для небольшого документа импортируйте оба файла через PdfFormatProvider, получите RadFixedDocument и вызовите Merge для присоединения второго документа. Для крупных файлов используйте PdfFileSource и PdfStreamWriter: переберите PdfPageSource и записывайте страницы напрямую в выходной поток. В этом режиме содержимое исходных страниц не декодируется и не строится целиком в памяти, что даёт выигрыш на больших пакетах.
- Выберите исходные файлы и откройте каждый отдельным потоком только на чтение.
- Для полной правки импортируйте их в RadFixedDocument; для простой сборки страниц создайте PdfFileSource.
- При объединении через модель вызывайте Merge в нужном порядке. При потоковой сборке последовательно передавайте страницы в PdfStreamWriter.WritePage или используйте BeginPage/WriteContent для дополнительного слоя.
- Для разделения выберите нужные диапазоны страниц и запишите каждый диапазон в отдельный выходной поток. В полной модели для диапазона доступно клонирование части документа.
- После операции сравните общее число страниц, закладки, формы и аннотации на контрольных файлах. В критичных процессах не ограничивайтесь проверкой размера файла.
Как заполнять PDF-формы и работать с цифровой подписью
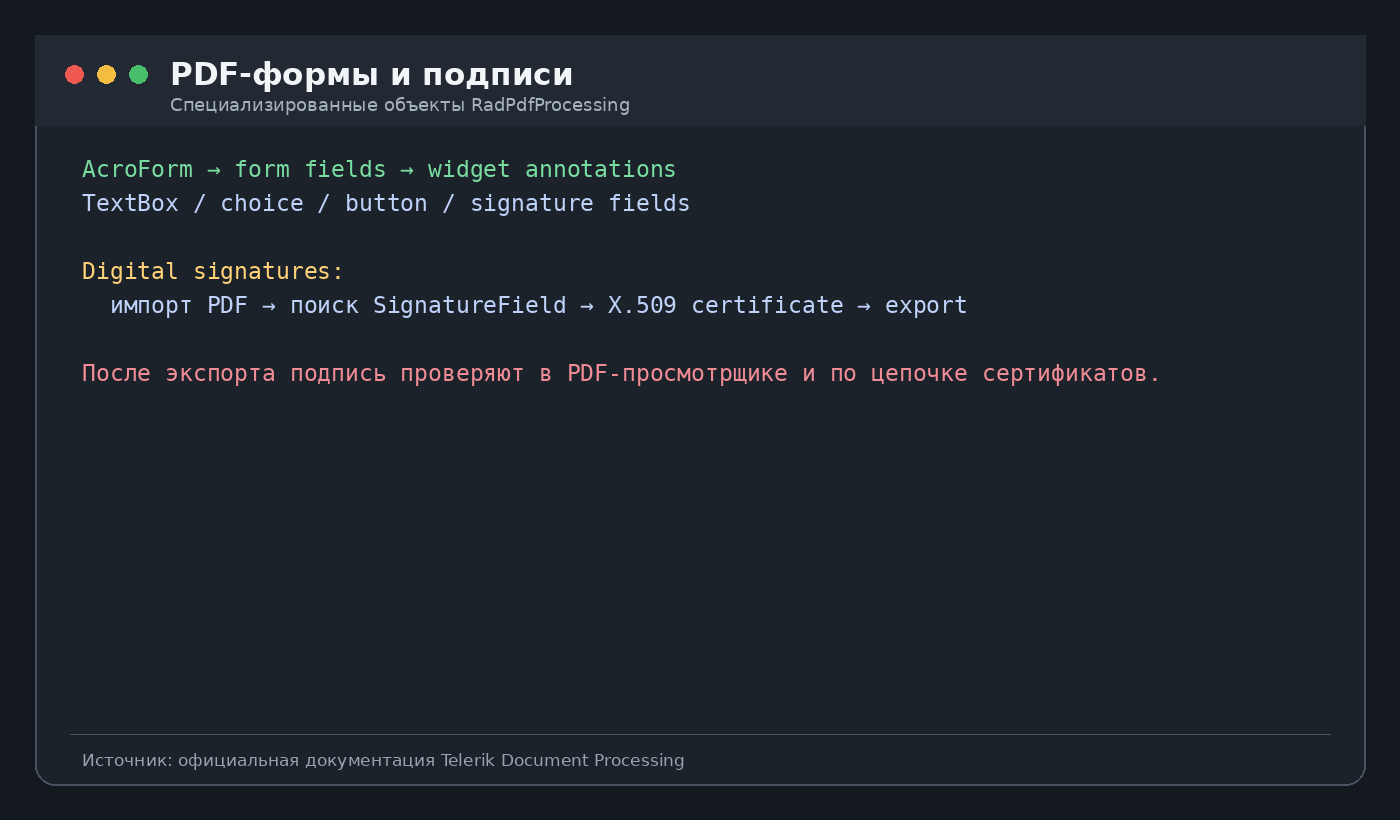
Interactive Forms в RadPdfProcessing основаны на AcroForm, form fields и widget annotations. Рабочий сценарий начинается с импорта PDF, затем код находит нужные поля по структуре формы, устанавливает значения и экспортирует документ. Для цифровой подписи используются signature fields и X.509-сертификаты; библиотека также умеет проверять существующие подписи и работать с несколькими подписями.
Источник: Telerik Document Processing documentation
Перед массовым заполнением создайте тест, который проверяет имена полей, тип каждого поля и число widget-аннотаций. После заполнения откройте результат в независимом просмотрщике и убедитесь, что значения видимы и сохраняются. После подписи отдельно проверяйте криптографический статус, цепочку доверия и факт отсутствия изменений после подписания. Сертификаты и управление удостоверяющими центрами находятся вне области ответственности библиотеки.
Как настроить шрифты и изображения на Linux, в контейнере и Blazor
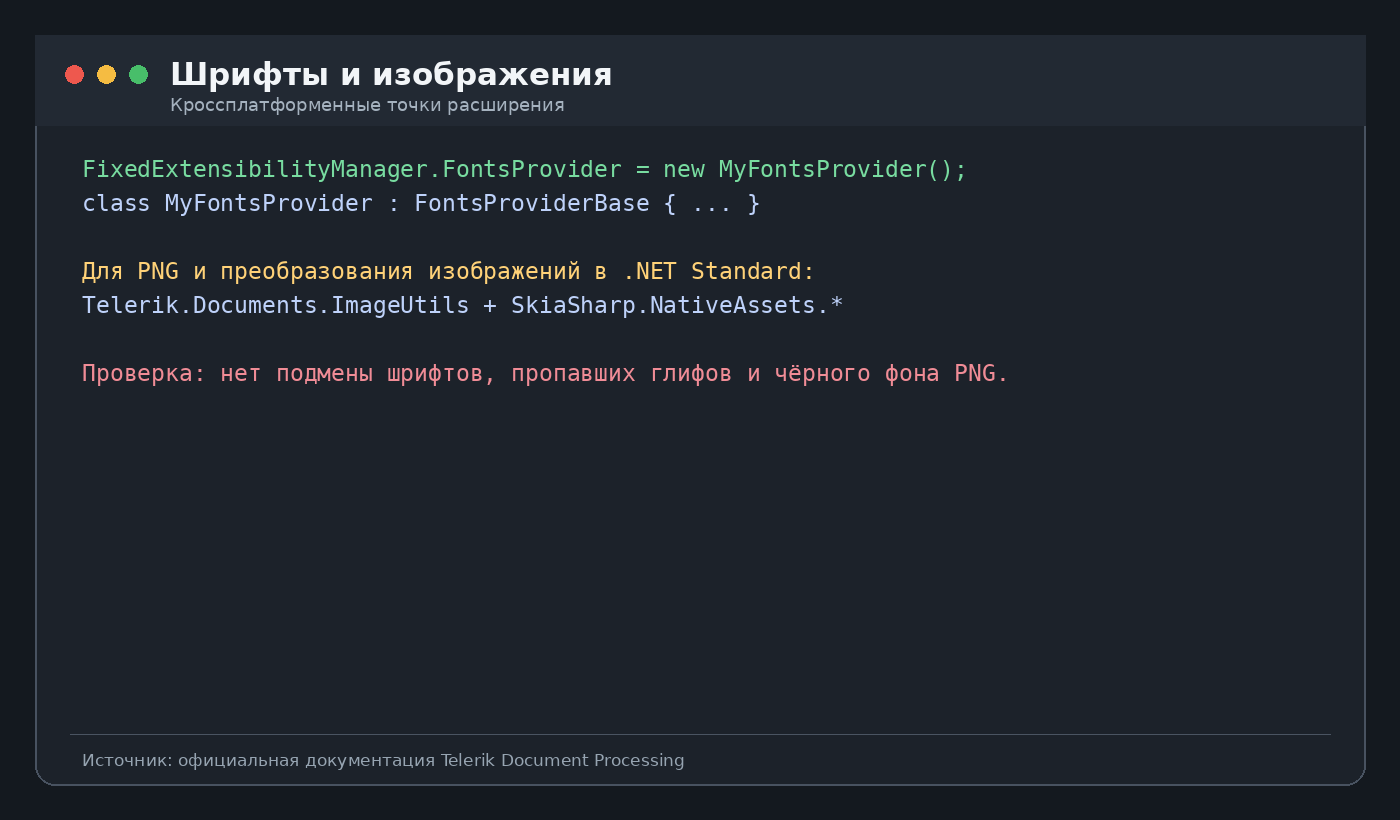
Кроссплатформенная сборка требует явной работы с ресурсами, которые desktop Windows обычно предоставляет автоматически. Для PDF-экспорта WordsProcessing приложение настраивает FontsProviderBase, чтобы библиотека могла получить байты нужного шрифта. Для обработки PNG и других изображений в .NET Standard применяются Telerik.Documents.ImageUtils и подходящий пакет SkiaSharp.NativeAssets.*; для Blazor WebAssembly добавляются соответствующие SkiaSharp-компоненты и wasm-tools.
Источник: Telerik Document Processing documentation
Настройку проверяйте не одним английским Hello World. Соберите PDF с кириллицей, несколькими начертаниями, символами валют, таблицей и PNG с прозрачностью. Затем сравните текстовый слой и изображение на Windows и целевой серверной платформе. Такой тест быстро обнаруживает отсутствующий файл шрифта, неверный SkiaSharp native asset и различие в метриках.
Типичные ошибки и как их исправлять
Большинство сбоев в Document Processing относится не к «кнопке, которая не работает», а к зависимостям, жизненному циклу потоков, отсутствующим ресурсам и различиям моделей документов. Диагностику удобнее вести сверху вниз: пакеты и лицензия, импорт, модель, настройки, экспорт, затем визуальная проверка.
Ошибка лицензии, trial-метка или TKL-сообщение
Источник: Telerik Document Processing documentation
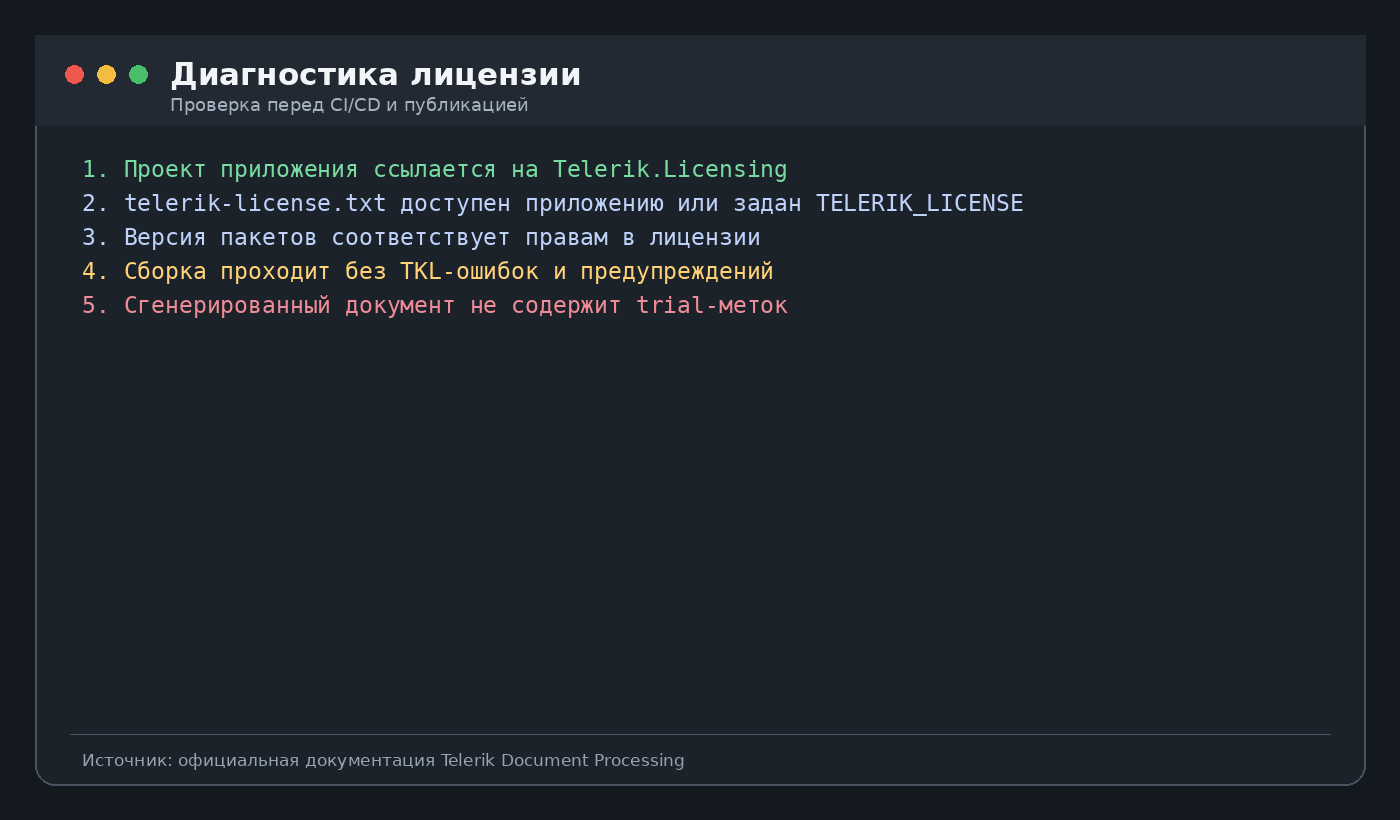
Проверьте, что корневое приложение, которое запускает Document Processing, ссылается на Telerik.Licensing. Убедитесь, что telerik-license.txt находится в домашней папке пользователя или в корне проекта, либо задайте TELERIK_LICENSE в окружении сборки. При обновлении пакетов обновляйте и лицензионный файл. В CI/CD храните значение как секрет. После исправления выполните чистую сборку и создайте тестовый документ: отсутствие предупреждений в логе недостаточно, если итоговый файл всё ещё содержит trial-индикацию.
PDF импортирован, но поток внезапно недоступен
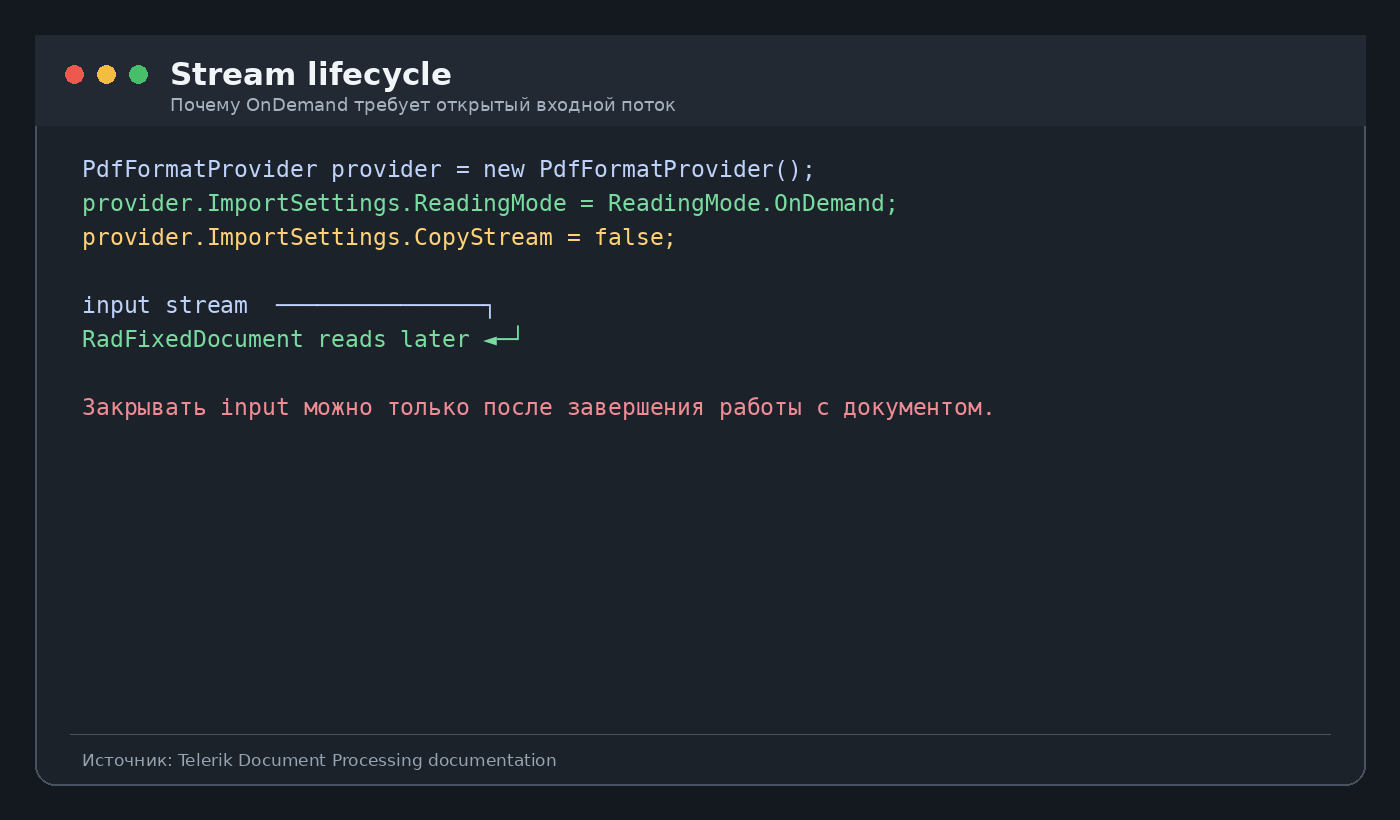
У PdfFormatProvider режим ReadingMode.OnDemand рассчитан на viewer-сценарии и читает содержимое страниц по мере необходимости. При CopyStream=false исходный Stream должен оставаться открытым, пока документ используется. Для серверной обработки без viewer обычно проще загрузить содержимое целиком и закрыть поток после импорта. Не выбирайте OnDemand как универсальную оптимизацию: документация прямо ограничивает его назначение.
В PDF пропали шрифты, символы или прозрачность изображения
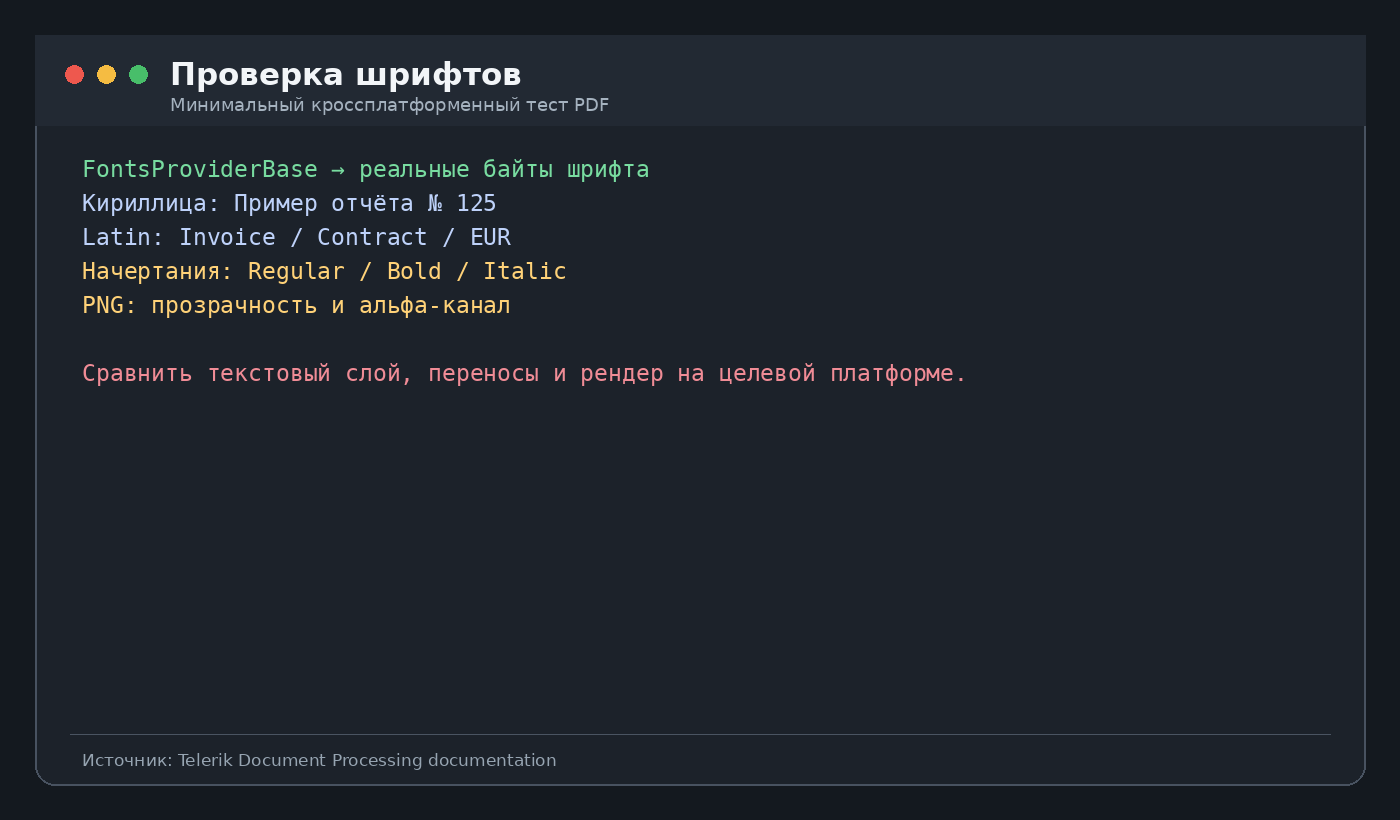
На кроссплатформенном .NET сначала проверьте FontsProviderBase и фактическое наличие файлов шрифтов в контейнере или хосте. Затем проверьте пакеты ImageUtils/SkiaSharp, когда в документе есть PNG, прозрачность или преобразование изображений. Не маскируйте проблему подстановкой другого шрифта в последнюю минуту: изменение метрик может сломать переносы и таблицы. После исправления сравните несколько эталонных страниц на уровне текста и визуального рендера.
Документ создался, но макет разъехался
Сначала определите, соответствует ли выбранный редактор задаче. Длинный отчёт, собранный через FixedContentEditor, требует ручного учёта свободного места и переносов. Для такого документа RadFixedDocumentEditor или RadWordsProcessing дают более естественный поток. Обратная ситуация возникает со штампами и точными оверлеями: там FixedContentEditor удобнее. Проверяйте страницы с максимальным количеством строк, длинными словами, пустыми полями и крупными изображениями — «средний» документ часто скрывает проблему.
Если пользовательский PDF нужно править вручную, отдельно стоит посмотреть практический разбор способов редактирования PDF. Он решает другую задачу: Telerik Document Processing автоматизирует операции в коде, а не заменяет готовый визуальный редактор.
Источник: Telerik Document Processing documentation
Источник: Telerik Document Processing documentation
Источник: Telerik Document Processing documentation
Источник: Telerik Document Processing documentation
Плюсы, минусы, альтернативы и итоговый выбор
Telerik Document Processing логично оценивать как инфраструктурный SDK. Он особенно силён там, где документы являются частью повторяемого бизнес-процесса: генерации договоров и счетов, серверных отчётов, конвейеров PDF, экспорта таблиц и пакетных преобразований. Покупать его как замену Acrobat или Word для ручной работы не имеет смысла: UI в комплекте отсутствует.
Плюсы
- Единый .NET-стек для PDF, Word-подобных документов, Excel-книг, больших табличных выгрузок и ZIP.
- UI-независимая архитектура: библиотеку можно встроить в backend, desktop, web и облачные процессы без автоматизации Office или Acrobat.
- Две модели работы с PDF: полная модель для редактирования и PdfStreamWriter для производительных операций со страницами.
- Практичные сценарии бизнес-документов: формы, цифровые подписи, mail merge, таблицы, формулы, экспорт Word/Excel в PDF.
- Отдельная потоковая библиотека для крупных XLSX/CSV снижает требования к памяти в массовых выгрузках.
Минусы
- Нет собственного визуального редактора: для конечного пользователя нужен отдельный UI или готовое приложение.
- Нельзя воспринимать набор как универсальный конвертер PDF ↔ Word ↔ Excel во всех направлениях; возможности зависят от конкретного FormatProvider.
- Кроссплатформенный PDF-экспорт требует осознанной настройки шрифтов и части графического стека.
- Коммерческая лицензия и механизм Telerik.Licensing становятся частью процесса сборки и CI/CD.
- Полноценная объектная модель больших Excel-файлов может быть ресурсоёмкой; переход на streaming API требует другой архитектуры записи.
Сравнение с реальными альтернативами
Aspose.Words, Aspose.PDF и Aspose.Cells предлагают отдельные .NET-библиотеки по форматам и ориентированы на широкую обработку и конвертацию документов. Syncfusion Document SDK объединяет библиотеки PDF, Word, Excel, PowerPoint и дополнительные инструменты; у него также есть отдельные viewer/editor SDK. iText — прежде всего PDF-платформа и уместен, когда основной контур задачи сосредоточен на создании, изменении и защищённой обработке PDF. В Telerik сильная сторона — сочетание PDF, flow-документов, spreadsheet-модели и тесная совместимость с другими Telerik UI-наборами в одном .NET-стеке.
Выбор между ними делайте по контрольному набору документов, а не по количеству пунктов в списке возможностей. Возьмите несколько реальных DOCX, PDF и XLSX с типичными таблицами, шрифтами, формулами и формами; реализуйте один и тот же импорт, изменение и экспорт; замерьте качество результата, память, время, размер файлов и сложность кода. Для документов юридического или финансового назначения отдельно проверяйте подписи, шифрование и сохранность метаданных.
Практическая рекомендация по сценариям
Источник: Telerik Document Processing documentation
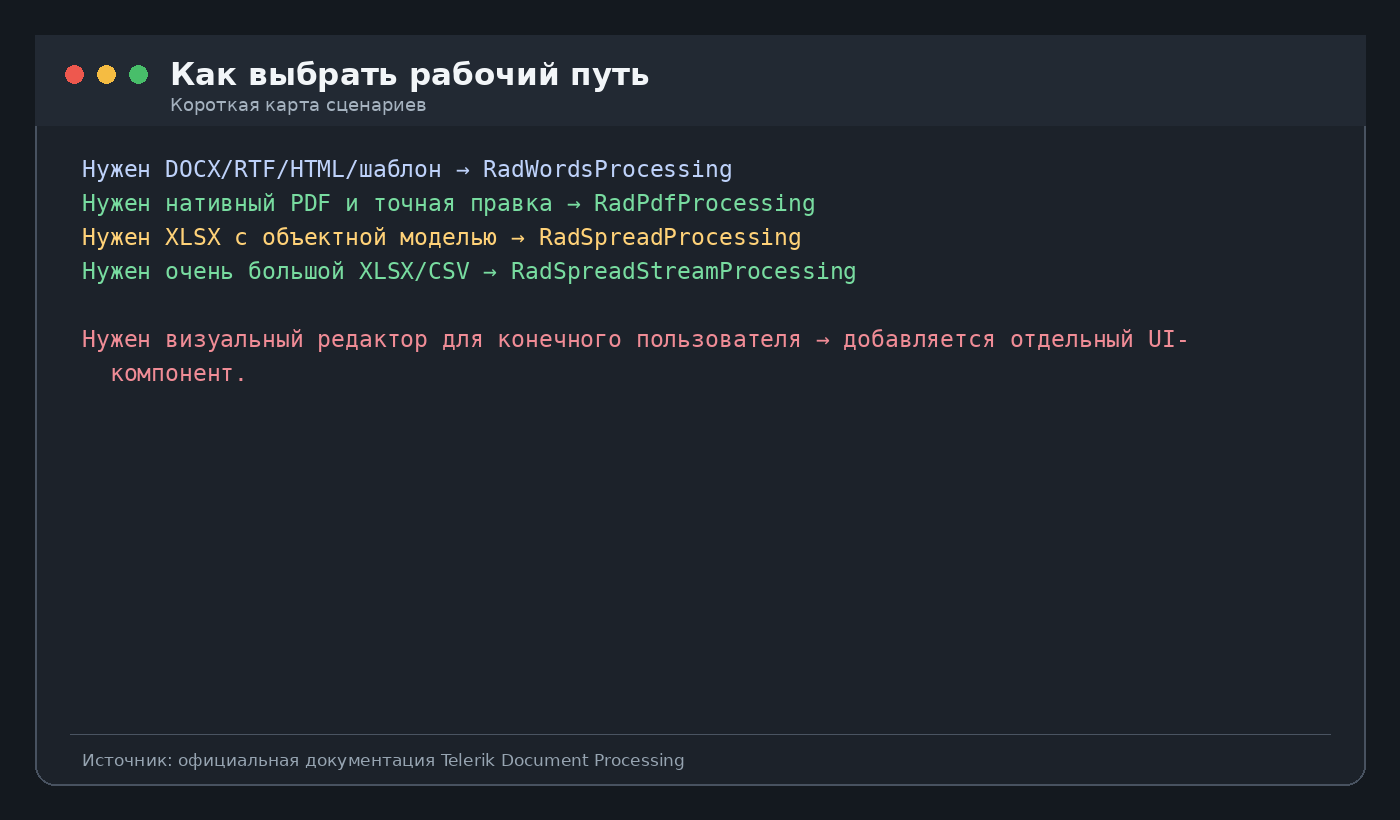
- Серверная генерация PDF. Начинайте с RadPdfProcessing. Для потокового текста выбирайте RadFixedDocumentEditor, для точных оверлеев — FixedContentEditor.
- Шаблонные договоры и письма. Используйте RadWordsProcessing, храните стили в DOCX-шаблоне и подставляйте данные через mail merge или управляемые элементы документа; PDF делайте финальным экспортом.
- Корпоративная отчётность XLSX. Используйте RadSpreadProcessing, пока нужен полный Workbook и редактирование. Для очень больших выгрузок переносите массовую часть в RadSpreadStreamProcessing.
- Объединение и разбиение больших PDF. Используйте PdfStreamWriter, когда страницы достаточно переносить без глубокой модификации содержимого.
- Ручная работа сотрудников. Добавляйте отдельный UI-редактор/просмотрщик или выбирайте готовое настольное приложение; сам Document Processing остаётся backend-библиотекой.
Перед внедрением зафиксируйте три вещи: набор реально используемых форматов, целевые платформы выполнения и пять-десять эталонных документов для регрессионных тестов. Затем подберите минимальные пакеты, настройте лицензию и шрифты, реализуйте один сквозной сценарий и только после стабильного экспорта расширяйте его формами, подписями, массовой обработкой и потоковой оптимизацией. Такой порядок лучше всего соответствует архитектуре Telerik Document Processing и снижает число трудно диагностируемых проблем.
Есть ли у Telerik Document Processing собственное окно редактора?
Нет. Это UI-независимые .NET-библиотеки. Визуальный интерфейс создаёт само приложение или предоставляет отдельный Telerik UI-компонент.
Нужен ли Microsoft Office для DOCX и XLSX?
Нет. Библиотеки создают, читают и экспортируют поддерживаемые документы программно без автоматизации Microsoft Office.
Можно ли напрямую превратить любой PDF в редактируемый Word или Excel?
Штатная модель RadPdfProcessing не является универсальным восстановителем DOCX/XLSX из произвольного PDF. Направления конвертации зависят от конкретного FormatProvider.
Что использовать для очень большого XLSX?
RadSpreadStreamProcessing предназначен для потоковой работы с большими табличными документами и снижает потребление памяти по сравнению с полной моделью Workbook.
Почему на Linux меняются шрифты в PDF?
Кроссплатформенному приложению нужно предоставить байты используемых шрифтов через FontsProviderBase и обеспечить наличие этих файлов в окружении.
Когда нужен PdfStreamWriter?
Когда требуется быстро объединять, разделять или переносить страницы больших PDF без построения полной модели документа и без изменения существующего контента страницы.